Cómo instalar y usar Open Code Review (ocr) paso a paso: proveedores, modos y salida JSON
En esta segunda parte de la guía instalamos Open Code Review (ocr), lo conectamos a un modelo y lo usamos para revisar cambios locales, commits y ramas completas. Todos los comandos y salidas son de la v1.13.2 ejecutada sobre tienda-api, una pequeña API Express de ejemplo con varios fallos plantados a propósito. Si no sabes qué es la herramienta ni cómo funciona por dentro, empieza por la parte 1.
Requisitos
- Git 2.41 o superior (
git --version).ocrusa Git para el diff, las búsquedas y el merge-base. - Node.js 18 o superior, solo si instalas con npm.
- Un LLM con soporte de herramientas (API key de Anthropic, OpenAI, DeepSeek, OpenRouter, Gemini, un Ollama local…). No hace falta si vas a usar el modo delegación con Claude Code.
Paso 1: instalar ocr
Con npm (recomendado)
npm install -g @alibaba-group/open-code-review
ocr version
El paquete npm descarga el binario de tu plataforma y se actualiza solo: en cada ejecución comprueba en segundo plano si hay versión nueva (como mucho cada 18 minutos). Para desactivarlo, por ejemplo en CI o si quieres versiones fijas:
export OCR_NO_UPDATE=1
npm install -g @alibaba-group/open-code-review@1.13.2
Con Homebrew (macOS y Linux)
brew install open-code-reviewCon el script de instalación
curl -fsSL https://open-codereview.ai/install.sh | shEn Windows (PowerShell 5.1 o superior):
irm https://open-codereview.ai/install.ps1 | iexAcepta OCR_INSTALL_DIR (por defecto /usr/local/bin, o %LOCALAPPDATA%\Programs\ocr en Windows) y OCR_VERSION para fijar una versión.
Binario de GitHub Releases (sin Node)
Es lo que usamos nosotros en la prueba:
curl -Lo ocr https://github.com/alibaba/open-code-review/releases/latest/download/opencodereview-linux-amd64
chmod +x ocr && sudo mv ocr /usr/local/bin/ocr
Hay binarios para darwin-arm64, darwin-amd64, linux-amd64, linux-arm64, windows-amd64.exe y windows-arm64.exe, y un sha256sum.txt para verificarlos:
curl -LO https://github.com/alibaba/open-code-review/releases/latest/download/sha256sum.txt
shasum -a 256 -c sha256sum.txt --ignore-missing
El binario estático no se actualiza solo. Todo lo que ocr guarda va a ~/.opencodereview/: borrar esa carpeta es una desinstalación limpia.
Paso 2: conectar un modelo
Opción interactiva
ocr config provider   # elige proveedor, pega la API key y el modelo
ocr config model      # cambia de modelo más tarde
Al terminar, ocr config provider lanza ocr llm test para comprobar que la conexión funciona. Puedes ver los 30 proveedores integrados con ocr llm providers.
Opción por comandos (CI, servidores, scripts)
Así quedó nuestra configuración con Anthropic. Usamos una clave falsa a propósito para enseñar el error de autenticación real:
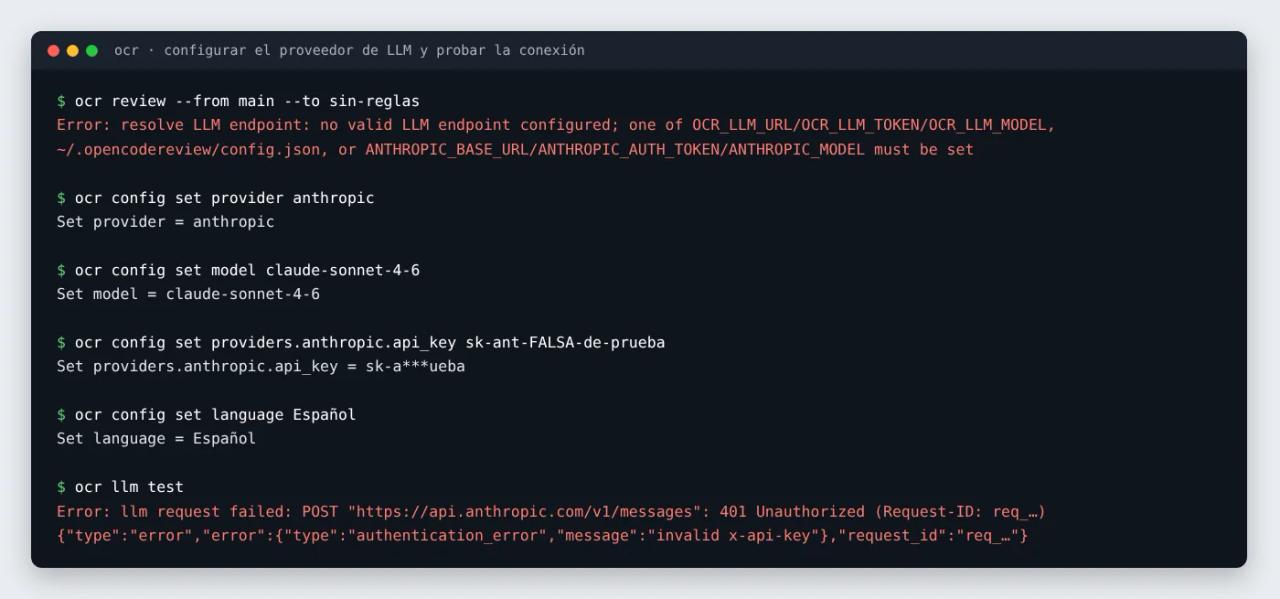
ocr config set provider anthropic
ocr config set model claude-sonnet-4-6
ocr config set providers.anthropic.api_key "$ANTHROPIC_API_KEY"
ocr config set language Español
ocr llm test
language controla el idioma de los comentarios de la revisión (inglés por defecto). Todo se guarda en ~/.opencodereview/config.json con permisos 0600:
{
    "provider": "anthropic",
    "providers": {
        "anthropic": {
            "api_key": "sk-ant-…",
            "model": "claude-sonnet-4-6"
        }
    },
    "language": "Español"
}
Otros proveedores habituales
DeepSeek u OpenRouter (cualquier proveedor integrado sigue el mismo patrón):
ocr config set provider deepseek
ocr config set providers.deepseek.api_key "$DEEPSEEK_API_KEY"
ocr config set model deepseek-v4-pro
Un modelo local con Ollama se añade como proveedor personalizado. La API key es obligatoria aunque Ollama la ignore:
ocr config set provider                          ollama
ocr config set custom_providers.ollama.url       http://127.0.0.1:11434/v1
ocr config set custom_providers.ollama.protocol  openai
ocr config set custom_providers.ollama.model     qwen3:32b
ocr config set custom_providers.ollama.api_key   ollama
Elige un modelo con *tool calling* nativo (la etiqueta "tools" en ollama.com). ocr hace toda la revisión mediante llamadas a herramientas; un modelo que solo las "narra" en texto, como deepseek-r1, termina en "No tool calls parsed" y cero comentarios. Si tu máquina es lenta, sube el timeout por petición con custom_providers.ollama.timeout_sec u OCR_LLM_TIMEOUT=900.
Sin guardar la clave en disco
Con api_key_cmd, ocr obtiene la clave de tu gestor de secretos en cada ejecución:
ocr config set providers.anthropic.api_key_cmd "op read op://dev/anthropic/api-key"
# macOS Keychain
ocr config set providers.anthropic.api_key_cmd "security find-generic-password -s ocr-anthropic -w"
Y si ya tienes variables de entorno, no hace falta configurar nada: ocr lee ANTHROPIC_API_KEY, OPENAI_API_KEY, etc. según el proveedor, y también el trío ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN y ANTHROPIC_MODEL que usa Claude Code, o el suyo propio OCR_LLM_URL, OCR_LLM_TOKEN y OCR_LLM_MODEL.
Paso 3: mirar qué se va a revisar (sin gastar tokens)
Antes de la primera revisión, usa --preview. Ejecuta todo el filtro de archivos pero no llama al modelo. Este es nuestro repo de ejemplo, con una rama feat/cupones que añade un módulo de cupones, su test, un .env, un bundle en dist/ y un PNG:
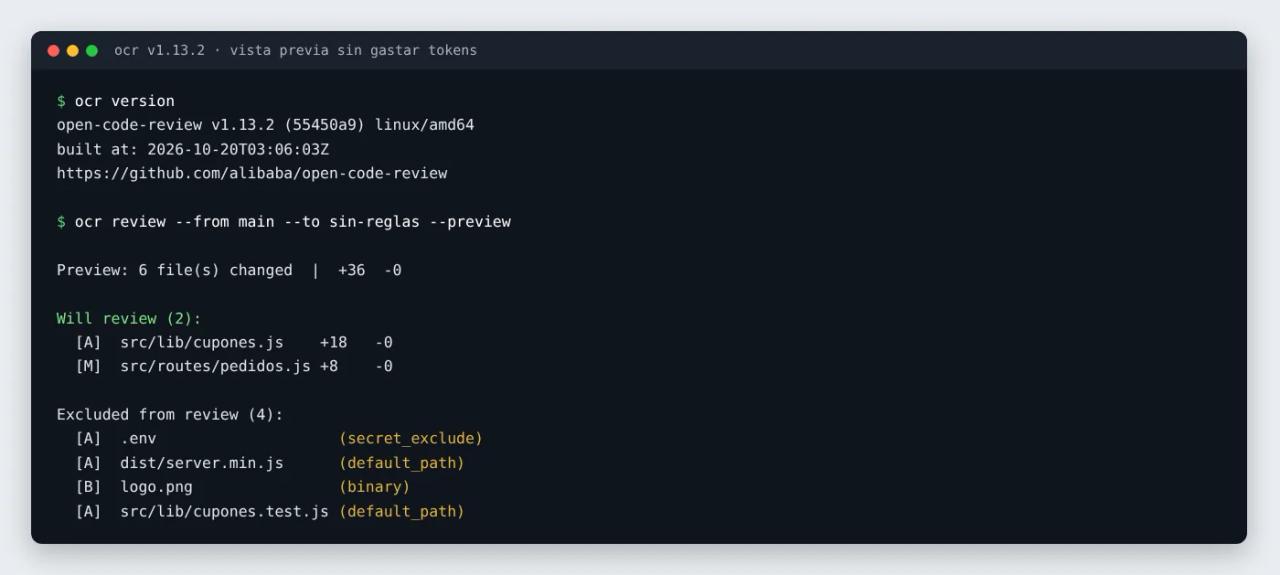
ocr review --from main --to feat/cupones --previewCada exclusión trae su motivo:
| Motivo | Qué significa | ¿Se puede forzar? |
|---|---|---|
| `secret_exclude` | Ruta de secretos: `.env`, `.env.*` (salvo `.example`, `.sample`, `.template`), `.ssh/`, `id_rsa`, `.npmrc`, `.netrc`… | No |
| `binary` | Archivo binario | No |
| `user_exclude` | Coincide con tu `exclude` o `--exclude` | Quitándolo |
| `default_path` | Tests, fixtures, snapshots, código generado, `node_modules`, `vendor`, `dist`, `target`… | Sí, con `include` |
| `unsupported_ext` | Extensión fuera de la lista de soportadas | Sí, con `include` |
| `provider_directory` | `vendor/`, `node_modules/`… en la raíz del repo, filtrado al leer el diff | No |
| `too_large` | El diff solo ya supera el 80 % del límite de tokens | Subiendo `--max-tokens` |
Con -f json obtienes lo mismo en un formato que puedes procesar: un array files con will_review y exclude_reason, más los totales reviewable_count y excluded_count.
Paso 4: la primera revisión
Desde la raíz de cualquier repositorio:
# Cambios locales: staged + unstaged + archivos nuevos
ocr review

# Una rama completa, tal como se vería en el pull request
ocr review --from main --to feat/cupones

# Un commit
ocr review --commit abc123
Flags que conviene conocer desde el primer día:
| Flag | Para qué | ||
|---|---|---|---|
| `-b "texto"` / `-B requisitos.md` | **Contexto de negocio**. Es lo que más mejora la revisión: "Añadimos cupones; los importes están en céntimos". | ||
| `--effort low\ | medium\ | high` | 1, 2 o 3 pasadas por grupo. `low` es la palanca de ahorro más grande. |
| `--exclude 'gen/**,**/*.sql'` | Excluir rutas solo en esta ejecución. | ||
| `--concurrency 4` | Menos subagentes en paralelo si chocas con límites de tu proveedor. | ||
| `--max-tokens-budget 2000000` | Tope total de tokens. Al llegar, publica lo revisado y marca el resto como `failed(budget)`. | ||
| `--provider` / `--model` | Cambiar de modelo para una sola ejecución. | ||
| `--timeout 30` | Minutos para toda la tarea (15 por defecto). | ||
| `--no-filter` | Desactivar el filtro final de comentarios (más hallazgos, más ruido). |
Un ejemplo completo para revisar la rama de cupones con contexto y esfuerzo alto:
ocr review --from main --to feat/cupones \
  --background "Cupones de descuento y pago en cuotas. Importes en céntimos." \
  --effort high
En modo texto verás el progreso de cada grupo y, al final, los comentarios con ruta, rango de líneas, explicación y sugerencia de código.
Paso 5: salida JSON y SARIF para otras herramientas
Para que otro programa o agente consuma el resultado:
ocr review --format json --audience agent > review.json--audience agent quita las líneas de progreso, así que en stdout solo queda un objeto JSON. Este es el formato documentado (en nuestra prueba no conectamos una API key de pago; la revisión completa con modelo la hicimos en modo delegación en la parte 4):
{
  "status": "success",
  "llm": { "provider": "anthropic", "model": "claude-opus-4-6" },
  "summary": {
    "files_reviewed": 9,
    "comments": 1,
    "total_tokens": 21344,
    "input_tokens": 18012,
    "output_tokens": 3332,
    "elapsed": "1m12s"
  },
  "comments": [
    {
      "path": "src/foo.go",
      "content": "Concurrent map access without a lock — wrap with sync.RWMutex.",
      "start_line": 42,
      "end_line": 47,
      "existing_code": "m[k] = v",
      "suggestion_code": "mu.Lock(); defer mu.Unlock(); m[k] = v",
      "thinking": "Looking at line 42, the map …"
    }
  ]
}
Un par de recetas con jq:
# Cuántos comentarios y cuántos tokens costó
jq '.summary | {comments, total_tokens, elapsed}' review.json

# Lista legible: archivo:línea  comentario
jq -r '.comments[] | "\(.path):\(.start_line)  \(.content)"' review.json
Si un comentario trae start_line: 0, el modelo parafraseó el código y no se pudo anclar: el hallazgo es válido, pero tendrás que localizarlo tú.
Para GitHub Code Scanning, --format sarif genera un informe SARIF 2.1.0 (lo usamos en la parte 5). Y con -o archivo escribes directamente a disco en UTF-8.
Revisar archivos completos con ocr scan
ocr review necesita un diff. Para auditar un proyecto heredado o una carpeta entera, usa scan:
ocr scan --preview                     # qué archivos entrarían
ocr scan --path src/lib,src/routes     # solo esas rutas
ocr scan --format json -o scan.json    # todo el repo a JSON
Por defecto agrupa los archivos, hace un plan por archivo, elimina duplicados y termina con un resumen del proyecto. Puedes saltarte pasos con --no-plan, --no-dedup y --no-summary para gastar menos.
Sesiones: reanudar, comparar y ver en el navegador
Cada revisión queda guardada como JSONL en ~/.opencodereview/sessions/. Con eso puedes:
ocr session list                         # sesiones del repo actual
ocr session comments <id>                # los hallazgos de una sesión
ocr session compare <antes> <después>    # nuevos, persistentes y resueltos
ocr session export <id>                  # HTML autocontenido para compartir
ocr review --from main --to feat/cupones --resume <id>   # reanudar una revisión cortada
ocr viewer                               # interfaz web en localhost:5483
El visor muestra cada llamada al modelo por fases (plan, revisión, filtro, compresión de memoria, reubicación). Es la forma de responder a "¿por qué ha dicho esto?" o "¿por qué este archivo no tiene comentarios?". Además permite marcar hallazgos como corregidos o ignorados mientras trabajas.
Errores frecuentes
Error: resolve LLM endpoint: no valid LLM endpoint configured No hay proveedor configurado ni variables de entorno. Ejecuta ocr config provider, o define OCR_LLM_URL, OCR_LLM_TOKEN y OCR_LLM_MODEL. Es exactamente lo que nos devolvió ocr review antes de configurar nada.
401 Unauthorized ... "invalid x-api-key" (o 403) La clave es incorrecta o ha caducado. Si tienes api_key y api_key_cmd a la vez, gana api_key y ocr avisa.
Cannot find merge-base El modo rango necesita historial. En CI, haz checkout con fetch-depth: 0. En local, git fetch origin main antes.
No tool calls parsed for ..., retrying... y luego Max tool requests reached El modelo no soporta *tool calling* nativo. Cámbialo por uno que sí lo tenga (qwen3, Claude, GPT, DeepSeek V4…).
WARNING: prompt tokens (...) exceed 80% of max_tokens Ese grupo es demasiado grande y se ha saltado. Excluye el archivo si es generado, divide el cambio o sube el límite con ocr config set max_tokens 400000 si tu modelo tiene más contexto.
El JSON sale con "comments": [] Mira status: skipped significa que no había nada revisable (comprueba --preview); complete con files_reviewed mayor que 0 significa que revisó y no encontró nada.
Preguntas frecuentes
¿Cuánto cuesta una revisión? Depende del modelo y del tamaño. En el benchmark del proyecto la media rondó entre 350K y 700K tokens por PR real. Activa la telemetría (ocr config set telemetry.enabled true y telemetry.exporter console) para ver los tokens por modelo, y usa --effort low y --max-tokens-budget para acotar.
¿Qué modelo uso? Según el benchmark del propio proyecto, Claude Opus da el mejor F1, y Qwen, GLM, GPT-5.5 y DeepSeek quedan cerca. Para empezar, cualquier modelo de gama alta con herramientas sirve; para reducir costes, prueba DeepSeek o un Qwen local.
¿Puedo tener varios proveedores y cambiar sobre la marcha? Sí. Configúralos todos y usa --provider y --model en cada ejecución.
¿Revisa mis tests? No por defecto: los archivos de test se excluyen. Puedes incluirlos con una regla include, como verás en la siguiente parte.
Conclusión
Con tres comandos (npm install, ocr config provider, ocr review) tienes un revisor funcionando, y --preview te deja ver qué va a mirar antes de pagar un token. Para revisiones serias, añade siempre --background con el objetivo del cambio.
Lo siguiente es adaptarlo a tu proyecto: en la parte 3 escribimos reglas propias con rule.json y vemos el error de orden que nos pilló a nosotros.
// código fuente
// kit para agencias
// implementación
Más sobre Agentes de IA
- Skills para tus agentes
- Claude Code
- Skills para tus agentes
- Claude Code

- Skills para tus agentes
- Claude Code