security-audit de Cloudflare: cómo auditar la seguridad de tu código con Claude Code (guía y prueba real)
security-audit es la skill que Cloudflare publicó para convertir a tu agente de programación (Claude Code, Codex, Cursor u otro con subagentes) en un auditor de seguridad del código fuente. No es un escáner de patrones: reparte el trabajo entre agentes aislados que mapean la arquitectura, cazan fallos, intentan refutar lo que encuentran y entregan un informe con trazas de archivo y línea. Se publica con licencia MIT.
En esta guía verás qué hace por dentro, cómo instalarla, cómo configurarla en un proyecto y cómo usarla en sus dos modos. Lo hemos probado en Claude Code 2.1.305 contra una API de facturas con tres vulnerabilidades plantadas a propósito: te enseñamos el resultado de cada modo, cuánto tardó y lo que cuesta.
Si las skills son nuevas para ti, lee antes la guía de skills de Claude Code.
Qué es security-audit y de dónde sale
Cloudflare la describe como "la skill que dio origen al harness de descubrimiento de vulnerabilidades de Cloudflare". En su artículo *Build your own vulnerability harness* (junio de 2026) cuentan que ese sistema empezó como una skill de unas 450 líneas que auditaba un repositorio y que luego convirtieron cada fase en un agente propio con base de datos y orquestador. Esta skill es el punto de partida para un solo repositorio.
Datos comprobados en el repositorio cloudflare/security-audit-skill:
| Dato | Valor |
|---|---|
| Licencia | MIT, Copyright (c) 2025-2026 Cloudflare, Inc. |
| Último commit revisado | `c1c8a8c`, 14 de septiembre de 2026 |
| Archivos de la skill | `SKILL.md` + 14 guías `.md` + esquema JSON + 2 validadores |
| Validadores | `validate-findings.cjs` y `validate-coverage-ledger.cjs`, sin dependencias |
| Requisitos | Agente con subagentes en paralelo, Node.js y un sandbox del sistema operativo para ejecutar código del proyecto |
La skill es agnóstica del agente: habla de "agente padre", "herramienta Task" y agentes research o general, y cada plataforma los traduce a sus propios subagentes. En Claude Code el padre es la sesión principal y los demás son subagentes lanzados con la herramienta Agent.
Cómo funciona: las seis fases de una auditoría completa
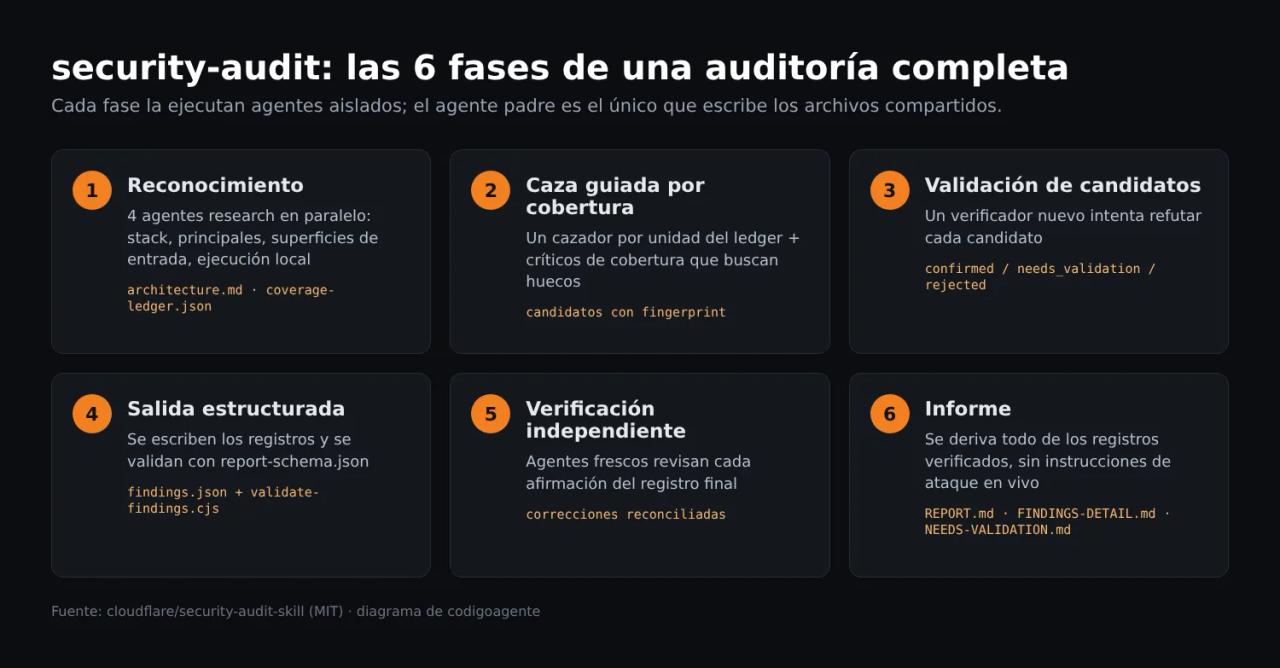
- Reconocimiento. Cuatro agentes leen el código en paralelo: producto y stack, principales y controles de autorización, superficies de entrada y destinos sensibles, y qué se puede ejecutar en local. El padre escribe
architecture.mdy un ledger de cobertura (coverage-ledger.json): una unidad por cada combinación de superficie de entrada, frontera de confianza, subsistema y clase de ataque. - Caza guiada por cobertura. Un cazador por unidad del ledger, cada uno con su directorio aislado. Después, un crítico de cobertura revisa qué quedó sin mirar y puede abrir unidades nuevas.
- Validación de candidatos. Cada candidato pasa a un verificador nuevo cuyo trabajo es intentar refutarlo. El agente que valida nunca es el que encontró el fallo.
- Salida estructurada. Los resultados se escriben en
findings.jsony se validan contrareport-schema.json. - Verificación independiente. Agentes frescos revisan las afirmaciones del registro final.
- Informe.
REPORT.md,FINDINGS-DETAIL.mdyNEEDS-VALIDATION.mdse derivan de los registros verificados, nunca al revés.
Los tres veredictos
Cada hallazgo termina en uno de estos estados:
| Veredicto | Qué significa | ¿Lleva severidad? |
|---|---|---|
| `confirmed` | Traza completa en el código **y** un resultado observado en local (en sandbox) que cruza una frontera real | Sí: critical, high, medium, low o informational |
| `needs_validation` | Hipótesis con traza en el código, bloqueada por un dato concreto que falta | No |
| `rejected` | Candidato refutado por el verificador | No |
Esta regla es la que más diferencia a la skill de un "revisa mi código" genérico: sin evidencia observada no hay severidad. Lo verás en la prueba.
Las clases de ataque
ATTACK-CLASSES.md define las clases base (inyección, control de acceso, manejo de archivos, criptografía y secretos, lógica de negocio, abuso de funciones y fugas de datos, vulnerabilidades encadenadas, un "comodín" y "lo obvio"). Además trae diez guías por dominio que solo se cargan si el reconocimiento encuentra esa frontera en el código: web y autenticación, cliente/navegador, IA y LLM, cadena de suministro, nube y despliegue, RPC y mensajería, agotamiento de recursos, aislamiento de datos, apps de escritorio y móviles, memoria y binarios.
Instalar la skill
Con la CLI de skills
Es el método del README. Instala la skill en el proyecto actual:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
Con --global queda disponible para tu usuario en todos los proyectos:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit \
  --global
Si no conoces esta CLI, en find-skills explicamos cómo buscar e instalar skills con ella.
A mano, copiando la carpeta
Si tu red bloquea skills.sh (nos pasó en el contenedor de pruebas), basta con clonar y copiar la carpeta skills/security-audit donde Claude Code busca skills:
git clone --depth 1 https://github.com/cloudflare/security-audit-skill /tmp/security-audit-skill
mkdir -p .claude/skills
cp -r /tmp/security-audit-skill/skills/security-audit .claude/skills/
Para instalarla para todos tus proyectos, cópiala en ~/.claude/skills/ en lugar de .claude/skills/. Al abrir Claude Code verás security-audit en la lista de skills y podrás llamarla con /security-audit.
Configurarla en un proyecto
La skill no tiene archivo de configuración: se configura con lo que le pides y con el entorno donde corre. Estos son los puntos que conviene dejar resueltos en el repositorio.
1. Dónde guarda los informes
Por defecto escribe fuera del repositorio, en ~/security-audit-skill/<repo>/run-<N>. Solo acepta un directorio dentro del proyecto si se lo pides explícitamente y Git lo ignora entero. Si quieres tener los informes junto al código, añádelo al .gitignore:
# Informes de security-audit (contienen rutas de ataque, no los subas)
/security-audit/
Y pídelo en el prompt: "guarda el informe en ./security-audit/run-1".
2. Perfil, alcance y presupuesto
| Perfil | Para qué | Comportamiento |
|---|---|---|
| `quick` | Repos pequeños, primera pasada, re-ejecuciones | Una oleada de cazadores, un crítico final y un verificador por candidato |
| `standard` | Por defecto | El flujo completo tal como está escrito |
| `deep` | Código crítico o grande | Unidades por subsistema y ciclo de vida, críticos hasta una pasada limpia y verificadores separados |
Puedes limitar el alcance ("solo src/api", "solo el diff entre v1.2.0 y main") y fijar un presupuesto en número máximo de agentes. La skill reserva primero los 4 de reconocimiento, los críticos y al menos un verificador; si el presupuesto no llega para eso, no lanza nada y te pide más margen.
3. Sandbox para ejecutar código
Para dar un fallo como confirmed la skill necesita reproducirlo en local, y solo ejecuta código del proyecto dentro de un sandbox del sistema operativo con todas estas garantías:
- sin red externa (como mucho, loopback aislado);
- entorno vacío con variables permitidas explícitamente y un
HOMEtemporal; - código y herramientas en solo lectura, escritura solo en su directorio
scratch/; - límites de CPU, memoria, procesos, tamaño de archivo, disco y tiempo.
Si falta cualquiera de ellas, no ejecuta nada y deja el hallazgo en needs_validation con un plan de validación. Tampoco instala dependencias ni deja que el build las descargue. Es decir: si quieres hallazgos confirmados, el agente tiene que correr en un entorno así (un contenedor sin red, con el repo montado en solo lectura y límites de recursos, por ejemplo). Nosotros no le dimos ninguno, a propósito, y el resultado lo verás abajo.
4. Una línea en CLAUDE.md
Para que todo el equipo la use igual, deja la convención en el CLAUDE.md del proyecto:
## Seguridad
- Auditorías con la skill `security-audit`. Informes en `./security-audit/run-<N>` (ignorado por Git).
- Perfil `quick` para cambios pequeños, `standard` antes de cada release.
- Nunca probar contra producción: solo código fuente y sandbox local.
Cómo usarla: modo guía y auditoría completa
La skill tiene dos modos y elige según cómo se lo pidas:
- Modo guía (por defecto): preguntas de seguridad, revisión de un archivo, triaje de un fallo concreto. Usa solo las partes de la skill que hagan falta y no crea archivos.
- Auditoría completa: cuando pides explícitamente "auditar" o "pentest" del código, una revisión "completa" o informes en archivos. Ejecuta las seis fases y escribe todos los artefactos.
Prompts de ejemplo del README:
security audit this codebase
find security vulnerabilities in ./src
do a security review, output to ~/audits/my-project
En español funcionan igual. Si la petición es ambigua, la skill hace una sola pregunta antes de crear archivos.
Prueba real: auditamos una API de facturas con tres fallos plantados
Escribimos una API mínima en Express + better-sqlite3 + JWT: cinco archivos, multiempresa (cada usuario pertenece a una empresa y el token lleva companyId). En src/routes/invoices.js dejamos tres fallos a propósito:
// Lista las facturas de la empresa del usuario, con búsqueda por cliente.
router.get("/", (req, res) => {
  const q = req.query.q || "";
  const rows = db
    .prepare(
      `SELECT id, customer, total FROM invoices
       WHERE company_id = ${req.user.companyId} AND customer LIKE '%${q}%'`
    )
    .all();
  res.json(rows);
});

// Devuelve una factura por id.
router.get("/:id", (req, res) => {
  const row = db.prepare("SELECT * FROM invoices WHERE id = ?").get(req.params.id);
  if (!row) return res.status(404).json({ error: "not found" });
  res.json(row);
});

// Descarga el PDF de una factura de la empresa del usuario.
router.get("/:id/pdf", (req, res) => {
  const row = db
    .prepare("SELECT pdf_file FROM invoices WHERE id = ? AND company_id = ?")
    .get(req.params.id, req.user.companyId);
  if (!row) return res.status(404).json({ error: "not found" });
  res.sendFile(path.join(PDF_DIR, req.query.file || row.pdf_file));
});
Inyección SQL en la búsqueda, IDOR entre empresas en GET /:id y path traversal con ?file=. El JWT, en cambio, está bien hecho (algoritmo fijado a HS256 y falla cerrada), para ver si la skill inventa problemas donde no los hay.
Modo guía: tres fallos en 23 segundos
Primero, una revisión rápida sin archivos, llamando a la skill por su nombre:
claude -p "/security-audit Revisión rápida en modo guía de src/: dime qué vulnerabilidades reales hay, con archivo y línea, severidad y el arreglo mínimo. No escribas archivos."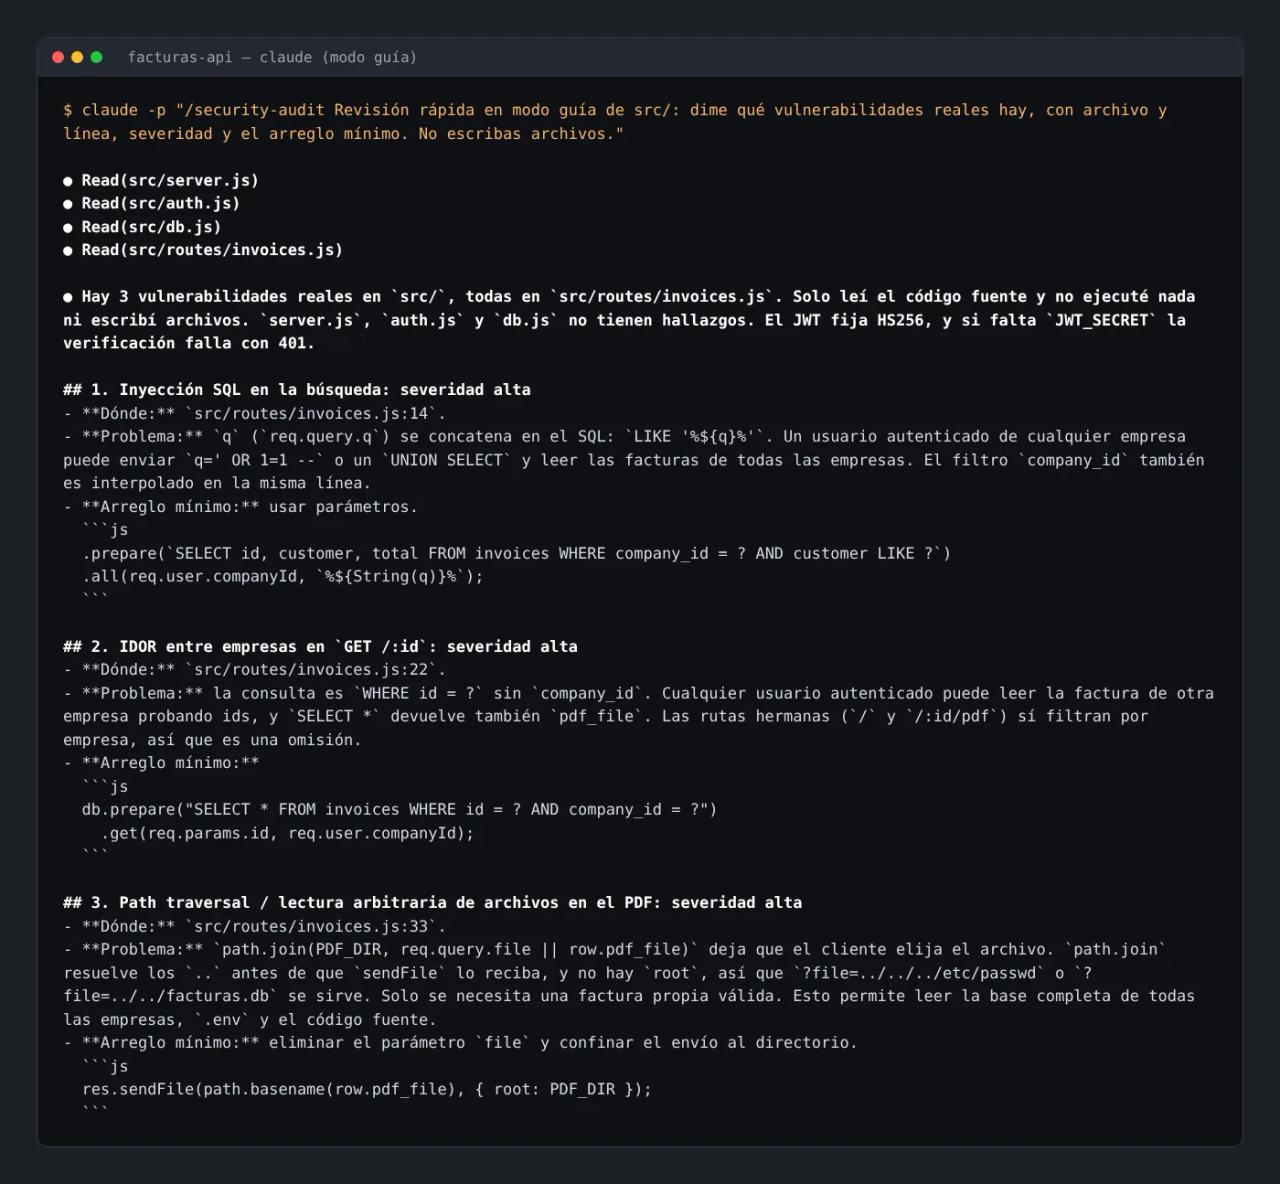
Encontró los tres fallos con su línea (14, 22 y 33), propuso el arreglo mínimo de cada uno y terminó sugiriendo tests de regresión (empresa A pidiendo una factura de la empresa B debe dar 404). Dio el JWT por correcto y no metió helmet ni el rate limit como vulnerabilidades. Tardó 23 segundos y 7 turnos.
Un detalle: la primera vez lo pedimos sin nombrar la skill ("revisa la seguridad de esta API") y Claude respondió sin cargarla. El resultado fue parecido en un caso tan pequeño, pero en un repo real la diferencia está en el método, así que llámala por su nombre (/security-audit o "usa la skill security-audit").
Auditoría completa con perfil quick
Después, el flujo completo con un presupuesto de 14 agentes y la orden de no ejecutar código del proyecto:
claude -p "Haz una auditoría de seguridad completa de este repositorio con la skill security-audit, perfil quick, presupuesto máximo de 14 agentes. Guarda el informe en ~/audits/facturas-api/run-1. No ejecutes el código del proyecto."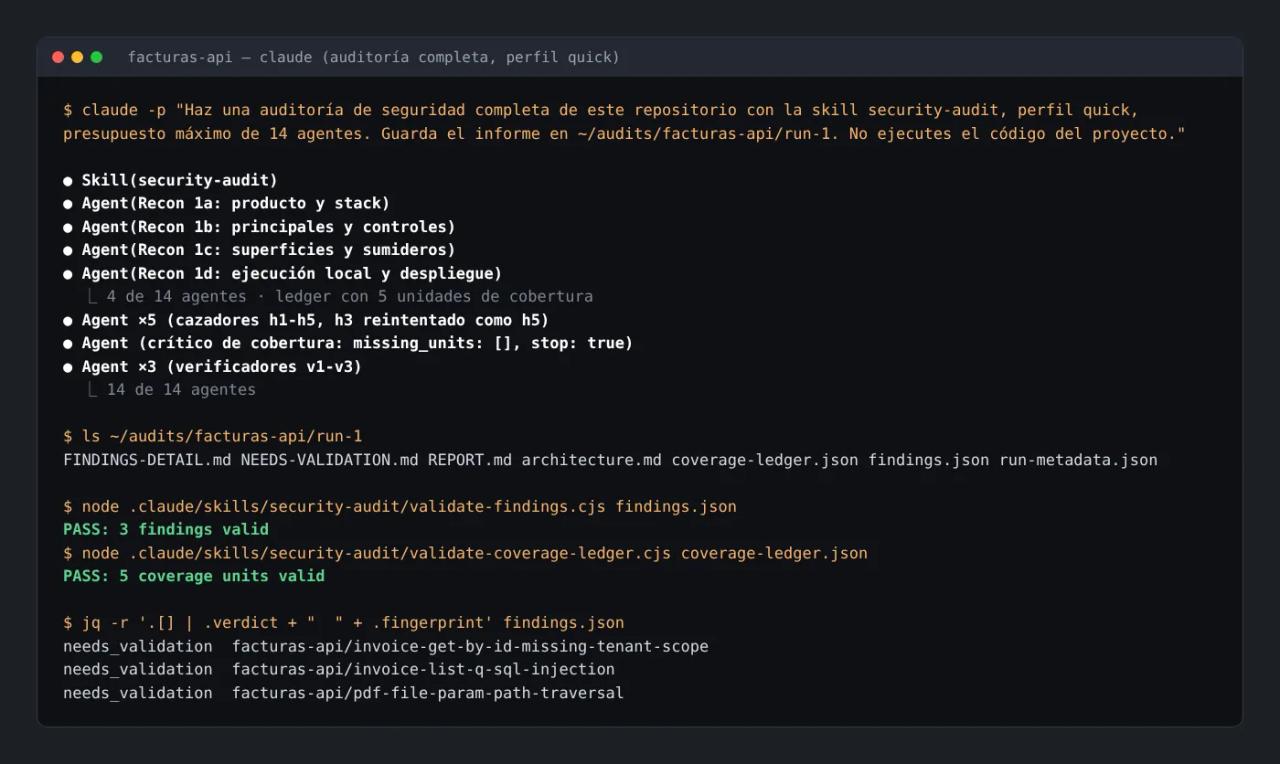
Lo que pasó, según la propia sesión y run-metadata.json:
- Reconocimiento: 4 agentes en paralelo. Seleccionó las guías
WEB-PROTOCOL-AND-AUTH.mdyDATA-ISOLATION-AND-LIFECYCLE.mdy descartó IA, nube, cadena de suministro y el resto porque el código no muestra esas fronteras. - Ledger: 5 unidades de cobertura (JWT, cableado de
server.js, listado,/:idy/:id/pdf). - Caza: 5 cazadores. Uno no devolvió JSON válido y la skill lo reintentó con otro agente en la misma oleada, dejándolo anotado en el informe.
- Crítico:
missing_units: [], sin huecos. - Verificación: 3 verificadores, uno por candidato. Los tres mantuvieron el candidato.
- Validadores:
PASS: 3 findings validyPASS: 5 coverage units valid.
Tardó unos 7 minutos. La sesión reportó un coste equivalente de 2,59 USD en tokens de API para un repo de cinco archivos; en un proyecto real escala con el número de unidades del ledger.
Por qué ninguno salió "confirmed"
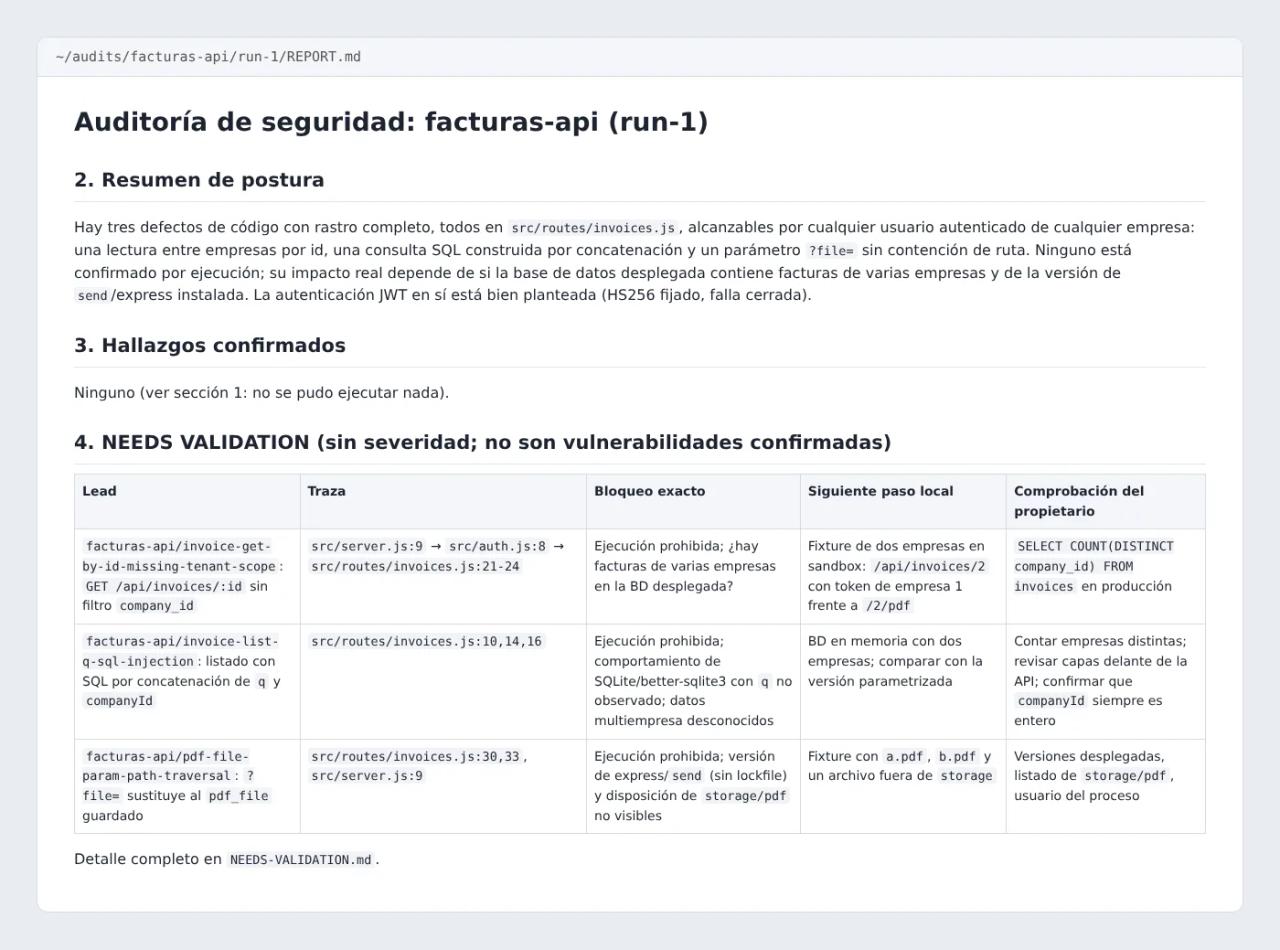
Los tres fallos son reales y las trazas son correctas, pero el informe dice "Hallazgos confirmados: ninguno". Es la regla de la skill funcionando: le prohibimos ejecutar código y no había sandbox verificable, así que no pudo observar el fallo y no le asigna severidad. Para cada uno deja:
- la traza (
src/server.js:9→src/auth.js:8→src/routes/invoices.js:22); - el bloqueo exacto (por ejemplo, "¿hay facturas de varias empresas en la base de datos desplegada?");
- un plan de validación local con datos ficticios (dos empresas, dos tokens, pedir la factura de la otra);
- una comprobación de solo lectura para el responsable (
SELECT COUNT(DISTINCT company_id) FROM invoices); - el arreglo mínimo (
WHERE id = ? AND company_id = ?).
En la práctica esto es lo que quieres de un auditor automático: prefiere quedarse corto antes que inflar un informe. Los arreglos coinciden con los del modo guía; la diferencia es que la auditoría completa deja constancia de lo revisado (el ledger) y de lo que falta por demostrar.
Ejecuciones repetidas y cobertura
Una sola pasada no agota un repositorio. El README lo dice claro: en sus pruebas, una ejecución encontró más o menos la mitad de las vulnerabilidades que encontraron varias ejecuciones juntas.
Las ejecuciones se suman. Si lanzas run-2 sobre el mismo repo, la skill lee los coverage-ledger.json y findings.json anteriores y:
- vuelve a verificar los
confirmedprevios si el código no cambió, y los revalida desde cero si cambió; - convierte en trabajo actual todo lo que quedó
needs_validation,deferredoblocked; - no deja que un
rejectedanterior tape la revisión de su unidad, solo esa afirmación concreta.
Un patrón razonable: quick en cada PR grande, standard antes de cada release y deep cuando toque código de autenticación, pagos o aislamiento entre clientes.
security-audit frente a /security-review de Claude Code
Claude Code trae un comando /security-review que revisa los cambios pendientes de la rama actual. Es rápido y útil antes de un merge. security-audit audita el repositorio entero (o el alcance que le marques), con ledger de cobertura, verificadores independientes y un esquema de salida validado. Se complementan: /security-review para el día a día, security-audit para auditorías periódicas.
Errores frecuentes
La skill no se activa. Con peticiones genéricas ("revisa esta API") Claude puede responder sin cargarla. Nómbrala: /security-audit ... o "usa la skill security-audit".
Todos los hallazgos salen needs_validation. No es un fallo: no había sandbox con las cuatro garantías o le prohibiste ejecutar código. Dale un entorno aislado si necesitas confirmed con severidad.
Se niega a guardar el informe dentro del repo. Solo lo acepta si Git ignora todo el directorio. Añádelo a .gitignore o usa la ruta por defecto en ~/security-audit-skill/.
incomplete_reason: "budget_cannot_fund_reconnaissance_and_reserves". El presupuesto no cubre los 4 agentes de reconocimiento más los críticos y un verificador. Sube el presupuesto, reduce el alcance o cambia a quick.
npx skills add no hace nada. Si tu red bloquea skills.sh, usa la instalación manual copiando skills/security-audit a .claude/skills/.
Preguntas frecuentes
¿Es gratis? La skill es MIT y gratuita. Pagas los tokens del modelo que use tu agente: en nuestra prueba, unos 2,59 USD de API para una auditoría quick de cinco archivos.
¿Funciona con Codex, Cursor u otros agentes? Está escrita para cualquier agente con subagentes en paralelo y herramientas de lectura. Nosotros solo la probamos en Claude Code.
¿Corrige el código? No. Describe el arreglo mínimo y los tests de regresión, pero no toca el código auditado.
¿Puede probar mi web en producción? No, por diseño. Prohíbe sondear endpoints desplegados, servicios externos o datos reales; todo es código fuente y sandbox local.
¿Sirve para proyectos con IA o agentes? Sí. Si el reconocimiento encuentra prompts, herramientas o MCP, carga AI-AND-LLM.md con clases como inyección de prompt, abuso de herramientas y confianza entre subagentes.
Conclusión
security-audit es la forma más seria que hemos visto de poner a un agente a auditar código: separa al que encuentra del que valida, deja constancia de qué se revisó y se niega a ponerle severidad a lo que no ha demostrado. Instálala en .claude/skills/, ignora la carpeta de informes en Git y empieza con un quick sobre tu proyecto. Si te interesa ver otras skills que cambian cómo trabaja el agente, sigue con Superpowers para Claude Code.
// código fuente
// kit para agencias
// implementación
Más sobre Agentes de IA
- Skills para tus agentes
- Claude Code
- Skills para tus agentes
- Claude Code

- Skills para tus agentes
- Claude Code