tdd y diagnosing-bugs: bucles de feedback para que el código de tu agente funcione
El tercer fallo que ataca el repositorio mattpocock/skills es el más frustrante: estás alineado con el agente, sabe lo que quieres, y aun así el código no funciona. La causa, según su autor, casi siempre es la misma: el agente programa a ciegas, sin bucles de feedback que le digan si lo que escribió hace lo que debe. tdd y diagnosing-bugs son las dos skills que construyen esos bucles: una para escribir código nuevo y otra para cazar fallos difíciles.
Es la sexta parte de la guía de las skills de Matt Pocock. Ambas skills tienen licencia MIT y las invoca el propio modelo cuando la tarea encaja (o tú con /tdd y /diagnosing-bugs).
Por qué van juntas
Las dos parten de la misma cita de *The Pragmatic Programmer*: "la velocidad del feedback es tu límite de velocidad". Y las dos dependen de lo mismo: un comando que se pone rojo cuando algo está mal y verde cuando está bien.
| `tdd` | `diagnosing-bugs` | |
|---|---|---|
| Cuándo | Construir una funcionalidad o arreglar un bug sencillo | Bugs que resisten, fallos intermitentes, regresiones de rendimiento |
| Bucle | Un test por ciclo, rojo → verde | Un comando que reproduce *este* fallo |
| Termina con | Comportamiento probado en costuras pactadas | Fix + test de regresión + limpieza |
| Lo usa | `implement`, `implement-spec` | Rampa de entrada del flujo principal |
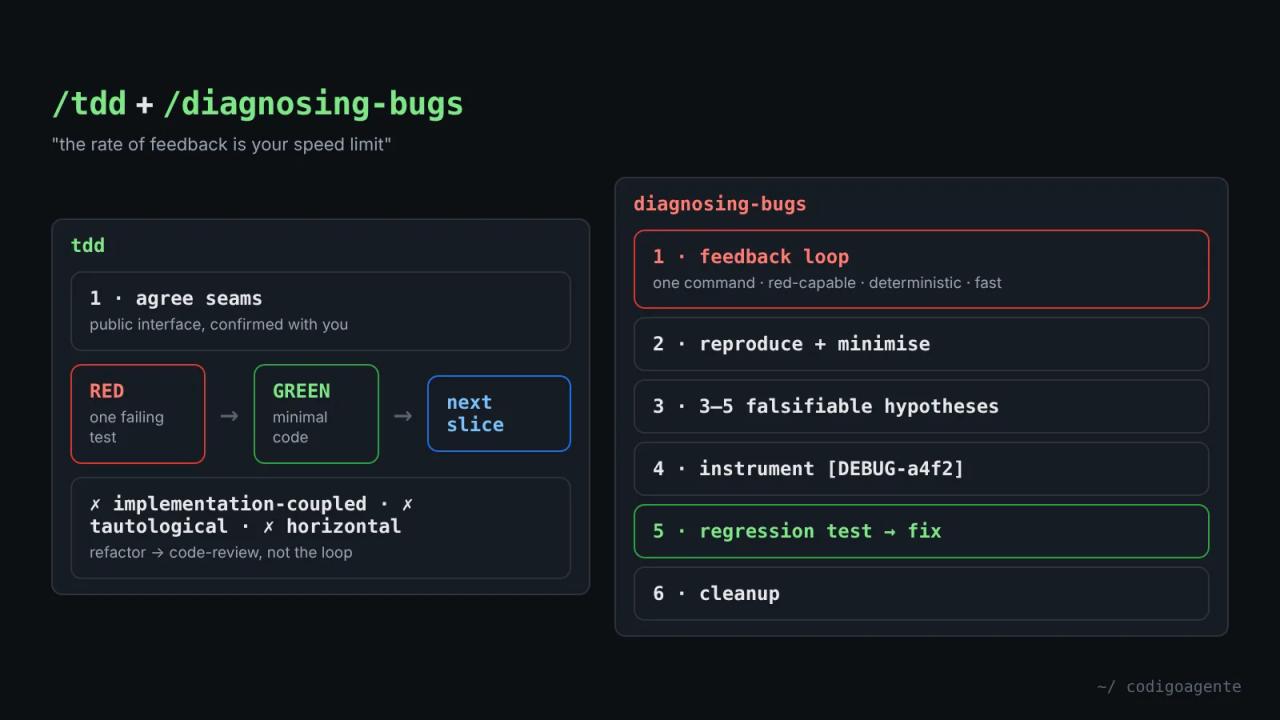
tdd: rojo-verde en costuras pactadas
tdd no es una explicación de qué es TDD. Es la referencia que hace que el bucle rojo → verde produzca tests que merece la pena conservar.
Qué es un buen test
Un buen test comprueba comportamiento a través de interfaces públicas, no detalles de implementación. Se lee como una especificación ("el usuario puede pagar con un carrito válido") y sobrevive a los refactors porque no le importa la estructura interna. La skill trae ejemplos de buenos y malos tests en tests.md y reglas de mocks en mocking.md: mockea solo en los límites del sistema (APIs externas, base de datos a veces, tiempo, aleatoriedad), nunca tus propios módulos.
Costuras pactadas antes de escribir un test
Esta es la regla que más cambia el comportamiento del agente. Una costura (*seam*) es la frontera pública donde observas el comportamiento sin meterte dentro. La skill dice:
Prueba solo en costuras pactadas. Antes de escribir cualquier test, anota las costuras y confírmalas con el usuario.
El agente te propone cada costura con una línea sobre qué detecta y qué no. Como no se puede probar todo, pactar las costuras al principio hace que el esfuerzo vaya a los caminos críticos y la lógica compleja, no a cada caso trivial. Si to-spec ya pactó las costuras, implement las reutiliza.
Los tres antipatrones
- Acoplado a la implementación: mockea colaboradores internos, prueba métodos privados o verifica por un canal lateral (consultar la base de datos en lugar de usar la interfaz). Se nota porque el test se rompe al refactorizar aunque el comportamiento no cambió.
- Tautológico: la aserción recalcula el valor esperado igual que el código (
expect(add(a, b)).toBe(a + b)). Pasa por construcción y nunca puede llevar la contraria al código. El valor esperado debe venir de una fuente independiente: un literal conocido, un ejemplo resuelto o el spec. - Rebanado horizontal: escribir todos los tests primero y luego todo el código. Comprueba comportamiento *imaginado*. Lo correcto es un test, una implementación mínima, y repetir.
Reglas del bucle
- Rojo antes que verde: primero el test que falla, luego solo el código justo para pasarlo.
- Una rebanada cada vez: una costura, un test, una implementación por ciclo.
- El refactor no es parte del bucle. Va en la revisión (
code-review), no en el ciclo rojo-verde.
diagnosing-bugs: un método para los fallos difíciles
diagnosing-bugs es para los bugs que no salen al primer vistazo: el fallo intermitente, la regresión que apareció entre dos versiones buenas, la lentitud sin causa clara. Son seis fases, y la skill pide no saltarse ninguna sin justificarlo.
Fase 1: construir el bucle de feedback
"Esta es la skill. Todo lo demás es mecánico." Si tienes una señal de pasa/falla que se pone roja con *este* bug, encontrarás la causa. Si no la tienes, mirar código no te salvará. La skill lista diez maneras de construirla, en este orden:
- Un test que falla en la costura que alcanza el bug.
- Un script
curlcontra el servidor de desarrollo. - Una invocación de CLI con una entrada fija comparada con una salida buena.
- Un script de navegador headless (Playwright o Puppeteer).
- Reproducir una traza capturada (petición, payload, log de eventos).
- Un arnés desechable con una parte mínima del sistema.
- Un bucle de fuzzing con 1.000 entradas aleatorias.
- Un arnés de bisección para
git bisect run. - Un bucle diferencial: misma entrada en la versión vieja y en la nueva.
- Como último recurso, un script bash con una persona en el bucle (
scripts/hitl-loop.template.sh).
Después hay que apretar el bucle: más rápido, con una señal más precisa y determinista. "Un bucle de 30 segundos que falla a veces es apenas mejor que nada; uno de 2 segundos determinista es un superpoder." Para fallos no deterministas, el objetivo es subir la tasa de reproducción: un fallo al 50 % se depura; uno al 1 % no.
La fase termina cuando puedes nombrar un comando que ya ejecutaste, que reproduce el síntoma exacto del usuario, que es determinista, rápido y que el agente puede lanzar sin ti. Si te pillas leyendo código para montar una teoría antes de tener ese comando, la skill te ordena parar.
Fases 2 a 6
- Reproducir y minimizar: confirmar que es el fallo que describió el usuario y no otro cercano, y recortar la reproducción hasta que cada elemento sea imprescindible.
- Hipótesis: entre 3 y 5, ordenadas y falsables ("si X es la causa, cambiar Y hará que desaparezca"). Se enseñan al usuario antes de probarlas, porque suele saber algo que las reordena.
- Instrumentar: una variable cada vez, depurador antes que logs, y cada log con un prefijo único como
[DEBUG-a4f2]para borrarlos todos con ungrep. En rendimiento, primero medir y después bisecar. - Fix y test de regresión: el test se escribe antes del fix, pero solo si hay una costura correcta. Si no la hay, eso es un hallazgo: la arquitectura impide blindar el fallo.
- Limpieza: reproducción original en verde, test de regresión pasando, cero
[DEBUG-...], prototipos borrados y la hipótesis correcta escrita en el commit o en el PR.
Una regla de seguridad que vale para cualquier depuración con IA: antes de enseñar comandos o salidas, el agente sustituye cada secreto por <REDACTED> y monta los bucles con variables de entorno.
Cómo se combinan
El flujo natural es este: tdd construye, diagnosing-bugs rescata cuando algo se rompe, y su fase 5 vuelve a tdd para el test de regresión. Si la fase 5 descubre que no hay ninguna costura donde fijar el fallo, el siguiente paso es retro (qué habría evitado el bug) o improve-codebase-architecture (crear esa costura), que vemos en la parte 8.
Un ejemplo con la newsletter de la parte 5: el ticket "Envío de números aprobados" se construye con tdd en la costura "enviar número" usando un adaptador falso del proveedor de correo. Si en producción algunos suscriptores reciben el correo dos veces, diagnosing-bugs empieza por un bucle que lanza el cron dos veces en paralelo contra ese adaptador y cuenta envíos por destinatario. Hasta que ese bucle no se pone rojo, nadie toca la clave de idempotencia.
Errores frecuentes
- Dejar que el agente escriba todos los tests de golpe. Es el rebanado horizontal que la skill prohíbe.
- Aceptar tests que mockean tus propios módulos. Se rompen en cada refactor.
- Pedir "arregla este bug" sin reproducción. El agente propondrá una teoría razonable y probablemente falsa.
- Dejar logs de depuración en el código. Con el prefijo único no hay excusa.
Preguntas frecuentes
¿Funciona con cualquier framework de tests? Sí. Las skills hablan de costuras e interfaces, no de Jest, Vitest o pytest.
¿Se activan solas? Sí, son invocadas por el modelo. Sus descripciones mencionan "red-green-refactor", "test-first", "diagnose" o "debug this", y cuando describes algo roto, que falla o va lento. También puedes llamarlas con /tdd o /diagnosing-bugs.
¿Y si el fallo solo ocurre en producción? La skill pide parar y decirlo, y pedirte acceso al entorno, un artefacto capturado (HAR, logs) o permiso para instrumentación temporal.
Siguiente paso
La próxima vez que tu agente diga "ya está arreglado", pídele el comando que demuestra que antes fallaba. En la parte 7 de la guía juntamos estas piezas con implement y code-review, la pareja que construye un ticket y lo revisa en dos ejes.
// código fuente
// kit para agencias
// implementación
Más sobre Agentes de IA
- Skills para tus agentes
- Claude Code
- Skills para tus agentes
- Claude Code

- Skills para tus agentes
- Claude Code