defending-code-reference-harness: el arnés de Anthropic para encontrar y corregir vulnerabilidades con Claude Code
Anthropic ha publicado defending-code-reference-harness, un arnés de referencia para encontrar y corregir vulnerabilidades en tu código con Claude Code. No es un escáner que instalas y olvidas: es el flujo completo que Anthropic ha visto funcionar en equipos de seguridad reales (modelo de amenazas, escaneo, verificación, triaje y parche), empaquetado como skills de Claude Code y un pipeline autónomo que se ejecuta en contenedores aislados.
Lo hemos clonado, leído de punta a punta y probado en Claude Code. Aquí verás qué incluye, cómo funciona cada etapa, cómo seguir el plan de "día 1 a semana 2" que propone, qué salió al lanzar /vuln-scan y qué límites tiene. Es para quien ya usa agentes para programar y quiere usarlos también para auditar su propio código.
Qué es defending-code-reference-harness
Es la implementación que acompaña al artículo de Anthropic Using LLMs to secure source code (copiado también en docs/blog-post.md). Recoge lo aprendido trabajando con equipos de seguridad de varias organizaciones desde el lanzamiento de Claude Mythos Preview.
Datos del repositorio a fecha de esta prueba (commit d3bea6b, 6 de agosto de 2026; paquete vuln-pipeline 0.2.1):
- Licencia: Apache-2.0, no MIT. Puedes usarlo, modificarlo y redistribuirlo, también en una empresa, pero si redistribuyes el código o una versión modificada debes conservar la licencia e indicar los cambios. Usarlo para auditar tu código no impone nada a tu código.
- Sin mantenimiento: el README dice textualmente que el repositorio no se mantiene ni acepta contribuciones. Tómalo como referencia para construir tu propio flujo, no como un producto con actualizaciones.
- Requisitos: Python 3.11+, Claude Code y, para el pipeline autónomo, un host Linux con Docker (gVisor solo funciona en Linux x86_64 o aarch64).
- Proveedor del modelo: funciona con la API de Anthropic, con un token de Claude Code (
claude setup-token) o con Bedrock; el artículo menciona también Vertex y Azure.
Si buscas algo gestionado, Anthropic remite a su producto Claude Security. Este repositorio es la versión abierta para quien quiera montar y adaptar su propio pipeline.
El bucle del defensor: las seis etapas
Todo el repositorio gira alrededor de un bucle de seis pasos. Los dos primeros se preparan una vez; los cuatro siguientes se repiten hasta que el escaneo deja de encontrar cosas nuevas.
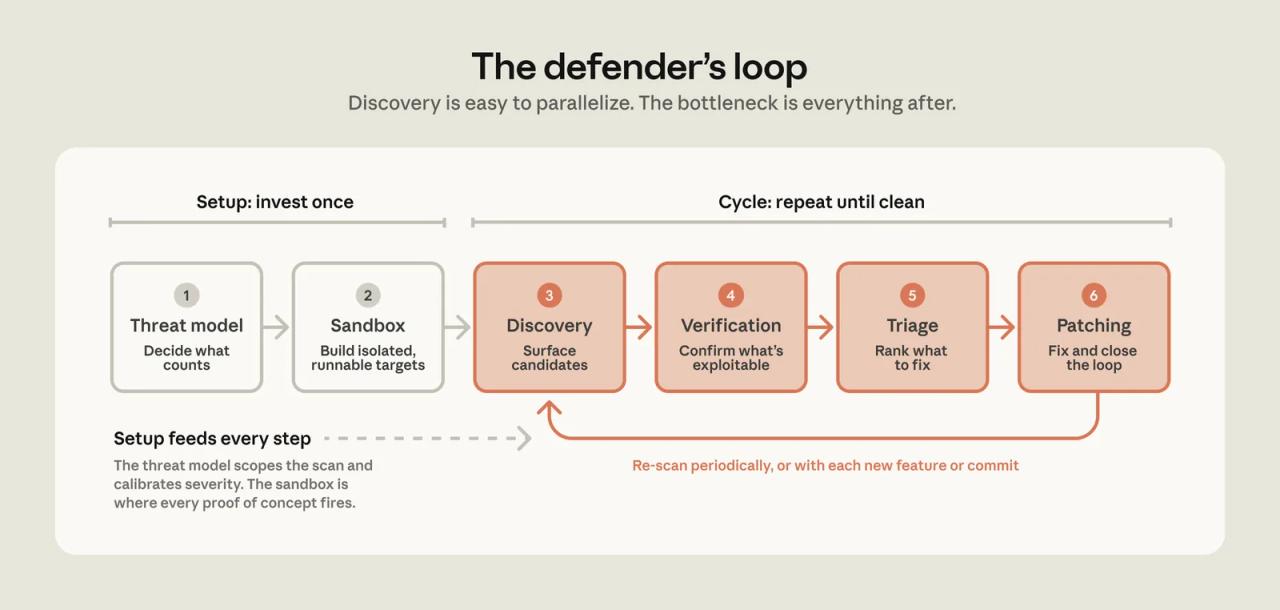
- Modelo de amenazas: decidir qué cuenta como vulnerabilidad en *tu* sistema.
- Sandbox: un entorno aislado donde compilar el objetivo y lanzar pruebas de concepto.
- Descubrimiento: sacar candidatos, cuantos más mejor.
- Verificación: confirmar cuáles son explotables de verdad.
- Triaje: quitar duplicados y ordenar por lo que hay que arreglar primero.
- Parche: arreglar, comprobar el arreglo y volver a escanear.
La frase que resume el diagrama es la importante: el descubrimiento es fácil de paralelizar; el cuello de botella es todo lo que viene después. Un modelo puede sacarte cien candidatos antes de comer, y si la mitad son ruido tu equipo dejará de leerlos.
Qué incluye el repositorio
Tres bloques, con niveles de riesgo distintos:
| Bloque | Qué es | ¿Ejecuta código del objetivo? |
|---|---|---|
| Skills interactivas | `/quickstart`, `/threat-model`, `/vuln-scan`, `/triage`, `/patch`, `/customize` en `.claude/skills/` | No (solo leen y escriben archivos), salvo `/customize`, que edita el arnés y ejecuta validaciones |
| `harness/` (`vuln-pipeline`) | Pipeline autónomo recon → find → verify → report → patch para memoria en C/C++ con ASAN | Sí: solo dentro de gVisor |
| Detección y respuesta | Skills `/dnr-hunt` y `/dnr-respond` + `dnr_harness/` (`dnr-pipeline`) | Las skills levantan la app de demo en `127.0.0.1`; el pipeline, en gVisor |
Y cinco objetivos de práctica en targets/:
canary: unentry.ccon tres bugs plantados (desbordamiento de heap, de pila y use-after-free). Sirve para comprobar que todo funciona en unos 6 minutos.drlibs: los decodificadores de audiodr_wav.hydr_flac.hfijados en un commit con dos CVE reales (CVE-2026-29022 y CVE-2025-14369).htslib(formatos de datos genómicos SAM/BAM/CRAM, CVE-2026-31962 a -31971) yalsa(topología de alsa-lib, CVE-2026-25068): dos bibliotecas C reales más, también fijadas en versiones vulnerables.dnrcanary: una app Flask vulnerable con una campaña de ataque escondida en una semana de logs generados.
Un detalle que conviene saber: .claude/settings.json añade la cabecera anthropic-cyber-runbook: skills a las peticiones de Claude Code, y el pipeline añade anthropic-cyber-runbook: pipeline y un token en el User-Agent. Es una marca declarada (cadenas fijas, sin contenido) para que Anthropic atribuya el uso; docs/pipeline.md explica cómo quitarla.
Día 1: modelo de amenazas, escaneo y triaje con las skills
El README propone un plan por días. El primero se hace solo con skills de Claude Code y no necesita sandbox, porque estas skills no compilan ni ejecutan nada: leen el código y escriben informes. Eso sí, ejecútalas en modo interactivo y aprueba cada uso de herramienta.
git clone https://github.com/anthropics/defending-code-reference-harness
cd defending-code-reference-harness

# Fija el modelo de todos los subagentes
export CLAUDE_CODE_SUBAGENT_MODEL=<model-id>
claude
Dentro de Claude Code:
> /quickstart
> /threat-model bootstrap targets/canary
> /vuln-scan targets/canary
> /triage targets/canary/VULN-FINDINGS.json
> /patch ./TRIAGE.json --repo targets/canary
Qué hace cada una:
/threat-model: conbootstrapredacta unTHREAT_MODEL.mda partir del código, la documentación, el historial de git y los CVE pasados (contexto, activos, puntos de entrada, fronteras de confianza y qué clases de bug importan). Coninterviewentrevista a quien conoce el sistema usando las cuatro preguntas de Shostack.bootstrap-then-interviewhace las dos cosas./vuln-scan: escaneo estático. Reparte el código en áreas de foco según el modelo de amenazas, lanza un subagente de revisión por área en paralelo y escribeVULN-FINDINGS.jsony.md. Sus herramientas permitidas son solo lectura (Read,Grep,Glob,rg,ls...) másWritepara el informe./triage: verifica cada hallazgo con varios votos independientes (3 por defecto,--votes 5para lotes importantes), junta duplicados por causa raíz, recalcula la severidad a partir de precondiciones y asigna un responsable. Con--autose salta la entrevista./patch: genera un diff candidato por hallazgo y un agente revisor independiente lo evalúa. En modo estático los diffs son inertes: nunca se aplican solos.
Al acabar tienes THREAT_MODEL.md, VULN-FINDINGS.{json,md}, TRIAGE.{json,md} y una carpeta PATCHES/.
Lo que pasó al probar /vuln-scan en el objetivo canary
Preparamos un proyecto de prueba limpio con la skill vuln-scan en .claude/skills/ y solo los archivos del objetivo canary (entry.c, Dockerfile, config.yaml y su THREAT_MODEL.md), sin las salidas de ejemplo que trae el repositorio, para que el agente no pudiera copiarlas. Lo lanzamos en modo no interactivo, limitado a las herramientas de solo lectura que declara la skill:
claude -p "/vuln-scan targets/canary" --output-format json \
  --permission-mode acceptEdits \
  --allowedTools "Read,Glob,Grep,Write,Task,Bash(ls:*),Bash(wc:*),Bash(head:*),Bash(rg:*),Bash(grep:*)"
Resultado: 49 segundos, 6 turnos y 0,16 USD con el modelo por defecto de nuestra instalación de Claude Code. Encontró los tres bugs plantados con su línea exacta:
| ID | Dónde | Qué | Confianza |
|---|---|---|---|
| F-001 | `entry.c:27` | `parse_alpha` copia una longitud controlada por la entrada (0-255) en un buffer de heap de 8 bytes | 0,95 |
| F-002 | `entry.c:40` | `parse_bravo` copia toda la entrada (hasta 4095 bytes) en `char name[16]` | 0,95 |
| F-003 | `entry.c:60` | `parse_charlie` libera el registro si el id es `0xff` pero no retorna, y luego escribe en memoria liberada | 0,93 |
Tres cosas que vimos y que conviene saber:
- No lanzó subagentes. La skill describe un subagente por área de foco, pero con un solo archivo C de 86 líneas el agente decidió hacer una pasada secuencial y puntuar la confianza él mismo. En un objetivo pequeño tiene sentido; en uno grande, comprueba en la transcripción que de verdad reparte el trabajo.
- Corrigió las líneas del modelo de amenazas. El
THREAT_MODEL.mdincluido cita los bugs en las líneas 25, 38 y 58; el agente avisó de que no coincidían y citó las que confirmó congrep(27, 40 y 60). Es exactamente el tipo de error que el repositorio pide revisar antes de mandar un informe a nadie. - Se dejó un hallazgo de baja severidad. La ejecución de ejemplo que trae el repositorio (
targets/canary/example_skill_runs/) encontró cinco candidatos, incluida una lectura de memoria sin inicializar enparse_alphacuando la longitud declarada es 0 (filtra un byte del heap por stdout). La nuestra no la vio. Es la variabilidad que el propio repositorio describe: el mismo prompt sobre el mismo código no devuelve siempre lo mismo, así que conviene hacer varias pasadas y unir los resultados.
No ejecutamos /triage sobre esta salida porque en el canary descarta los hallazgos a propósito (el código se declara de demostración), y no lanzamos el pipeline autónomo porque necesita gVisor sobre un host Linux con Docker. Para el triaje y el parche nos apoyamos en la ejecución de ejemplo incluida, que sí recorre las cuatro skills.
En esa ejecución, /triage --auto --votes 3 confirmó 4 de los 5 hallazgos por 3 votos a 0, absorbió un posible doble free como duplicado del use-after-free y dejó la lectura sin inicializar en LOW con una precondición (el atacante tiene que ver la salida estándar). Después, /patch --top 3 generó este diff para el desbordamiento de parse_alpha:
     size_t claimed = buf[0];  // length field from input, 0-255
     unsigned char *out = malloc(8);
     if (!out) return;
-    // Bug: trusts claimed length without bounding to allocation size.
+    if (claimed > 8) claimed = 8;
+    if (claimed > len - 1) claimed = len - 1;
+
     memcpy(out, buf + 1, claimed);
El revisor independiente lo aceptó (style_score 8) y el patch_result.json documenta las variantes revisadas y el intento de saltárselo. Pero fíjate en el detalle: con claimed = 0 el printf de la línea siguiente sigue leyendo out[0] sin inicializar. El parche arregla el desbordamiento, no la fuga de un byte, porque ese hallazgo LOW quedó fuera del --top 3. Por eso el repositorio insiste en que un humano tiene que leer cada diff como cualquier PR que llega de fuera.
Día 2: el pipeline autónomo con gVisor
El segundo día pasa de las skills a ejecuciones autónomas, donde los agentes sí compilan el objetivo y lanzan entradas maliciosas contra él. Por eso todo corre dentro de contenedores gVisor (un kernel en espacio de usuario entre el agente y tu máquina) con la salida a Internet limitada a la API de Claude mediante un proxy con lista blanca. Los subcomandos que lanzan agentes se niegan a arrancar fuera de ese sandbox salvo que pases --dangerously-no-sandbox.
# Preparación (una vez): venv, gVisor, imágenes de los agentes y proxy de salida
python3 -m venv .venv && .venv/bin/pip install -e .
./scripts/setup_sandbox.sh

# Autenticación: una de las tres
export ANTHROPIC_API_KEY=sk-ant-...
# export CLAUDE_CODE_OAUTH_TOKEN=<token de claude setup-token>
# export CLAUDE_CODE_USE_BEDROCK=1

export VULN_PIPELINE_MODEL=<model-id>

# Recon + find + verify + report sobre dr_libs
bin/vp-sandboxed run drlibs --runs 3 --parallel --stream --auto-focus --max-turns 100

# Un parche candidato por hallazgo
bin/vp-sandboxed patch results/drlibs/<timestamp>/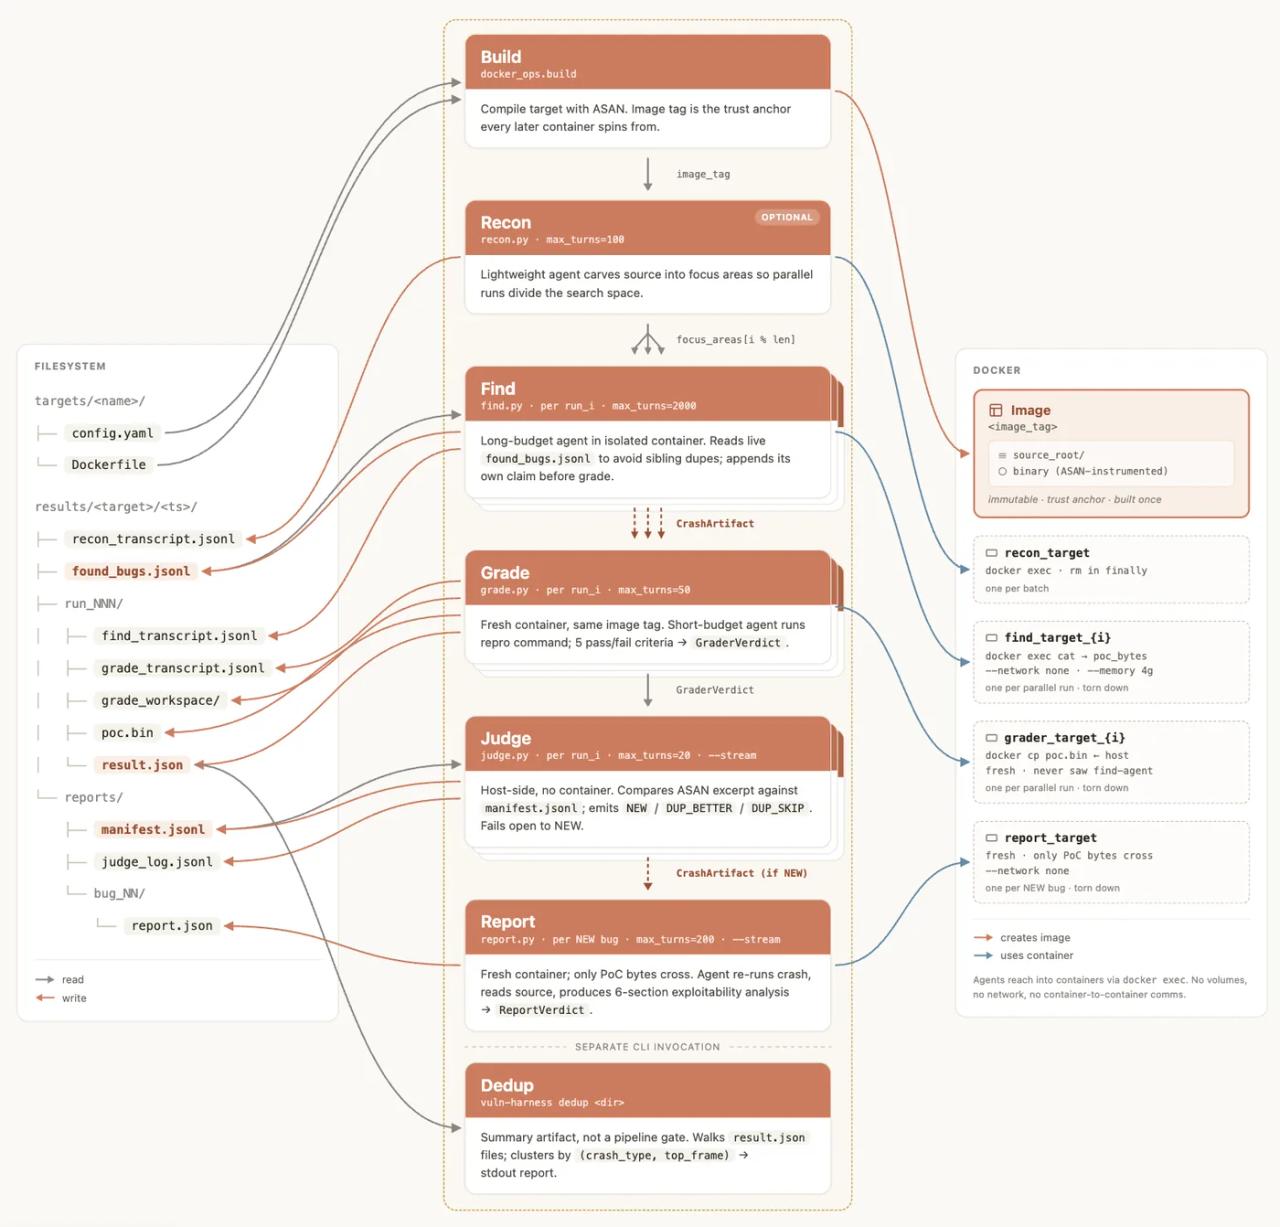
Las etapas, tal como están en harness/:
- Build: compila el objetivo con ASAN (el detector de errores de memoria de C/C++) en una imagen Docker. Esa imagen es el "ancla de confianza": todos los contenedores posteriores salen de ella.
- Recon (opcional,
--auto-focus): un agente ligero lee el código sin red y propone N subsistemas distintos que atacar por separado, para que los agentes en paralelo no acaben en el mismo bug. Endrlibspropone unas 14 áreas. - Find: N agentes en paralelo, cada uno en su contenedor con
--network noney 4 GB de memoria. Leen el código, fabrican entradas malformadas y ejecutan el binario hasta que una entrada lo rompe 3 de 3 veces. Consultanfound_bugs.jsonlen vivo para no repetir lo que ya encontró otro. - Grade: un agente calificador reproduce cada crash en un contenedor nuevo que el agente find nunca tocó. Lo único que cruza es el
poc.bin. - Judge: compara cada crash con los ya reportados y decide
NEW,DUP_BETTERoDUP_SKIP. - Report: un informe de explotabilidad por bug único (primitiva, alcanzabilidad, escalada, restricciones y severidad).
- Patch (comando aparte): propone el arreglo y lo pasa por una escalera de cuatro comprobaciones: compila, la PoC original deja de romperlo, los tests del proyecto siguen pasando y un agente find nuevo no consigue saltárselo en 50 turnos.
Con --stream, el primer informe (bug_00, la escritura fuera de límites de dr_wav) suele aparecer a los ~10 minutos. El CVE de dr_flac es de tipo DoS y el filtro por defecto lo descarta: necesitas --accept-dos y cuenta con 60-80 minutos hasta el primer crash.
Días 3 a 5: adaptarlo a tu lenguaje con /customize
El pipeline viene configurado para bugs de memoria en C/C++, pero su forma es genérica. Para portarlo a otro lenguaje o clase de vulnerabilidad solo hay que responder tres preguntas:
| Pregunta | Referencia C/C++ | Tu objetivo (ejemplos) |
|---|---|---|
| ¿Qué señal indica un hallazgo? | Firma de crash de ASAN | Excepción, archivo canario, callback DNS |
| ¿Qué forma tiene una prueba de concepto? | Archivo de entrada que provoca el crash | Secuencia de peticiones HTTP, lista de transacciones, test |
| ¿Cómo se compila y ejecuta? | `Dockerfile` con clang + ASAN | La build de tu lenguaje en un contenedor |
El flujo es pasar primero las skills del día 1 por tu código y dárselas a /customize, que crea targets/<tu-servicio>/ y modifica el arnés. Revisa su plan antes de aprobarlo, porque esta skill sí edita código y ejecuta comandos.
> /threat-model bootstrap-then-interview ~/code/mi-servicio
> /vuln-scan ~/code/mi-servicio
> /triage ~/code/mi-servicio/VULN-FINDINGS.json --repo ~/code/mi-servicio
> /customize use ~/code/mi-servicio/{THREAT_MODEL.md,VULN-FINDINGS.json} and ./TRIAGE.md
Y una ejecución de humo antes de escalar:
bin/vp-sandboxed run mi-servicio --runs 1Semana 2: el bucle exterior de escaneo, triaje y parche
A partir de aquí se trata de repetir: oleadas de ejecuciones, triaje de todo lo encontrado entre oleadas y parche de lo más grave.
bin/vp-sandboxed run mi-servicio --runs 5 --parallel --stream --auto-focus> /triage results/mi-servicio/ --repo ~/code/mi-servicio --auto --votes 5
> /patch results/mi-servicio/<timestamp>/La idea clave es que iterar rinde más que paralelizar. Si lanzas diez agentes a la vez, convergen en los mismos bugs superficiales. Si arreglas lo que encuentra la primera pasada y vuelves a escanear, el modelo ya no puede encontrar esos y busca otros, normalmente más profundos. Si no puedes parchear rápido, al menos apunta los bugs conocidos en known_bugs del objetivo para que las siguientes ejecuciones los eviten.
Detección y respuesta: cuando el atacante ya está en los logs
El paso 5 es opcional y cambia de enfoque: en lugar de prevenir, asume que alguien ya entró. El objetivo dnrcanary es una app web vulnerable con una semana de logs generados donde hay una ráfaga ruidosa de un escáner que falla y una campaña discreta que sí funciona.
pip install flask pyyaml
python3 targets/dnrcanary/generate_logs.py --seed 42> /dnr-hunt
> /dnr-respond INC-1/dnr-hunt obliga a llevar un registro por consulta (hipótesis, consulta, resultado, siguiente paso) y solo da un incidente por confirmed_exploited si se cumplen tres cosas: evidencia en logs, el fallo localizado en el código y una PoC disparada contra una instancia local. /dnr-respond termina en un plan (bloqueos, cuentas a suspender, credenciales a rotar) que nunca ejecuta: esa IP "atacante" puede ser un NAT con 400 usuarios legítimos detrás. Después puedes puntuar el resultado contra la verdad conocida con targets/dnrcanary/grade.py.
Las lecciones del repositorio que puedes aplicar sin usarlo
docs/best-practices.md y el artículo que lo acompaña valen por sí solos. Lo que más nos ha servido:
- El modelo de amenazas es la principal palanca contra los falsos positivos. Un equipo comprobó que con un modelo de amenazas bien definido el 90 % de los hallazgos eran explotables. Otro tenía un 40 % de "falsos positivos" que en realidad eran bugs reales que no encajaban en lo que el equipo consideraba amenaza. Escribe qué es de confianza (configuración, clientes autenticados) y qué no.
- Separa descubrir de verificar. Si pides al agente que encuentra que también filtre, se autocensura y descarta positivos reales. Un verificador adversarial independiente reduce a la mitad los hallazgos no explotables; exigirle además una PoC los deja casi en cero.
- Las restricciones van en código, no en el prompt. A un equipo le dijeron al modelo que no tenía red, la tenía, y el modelo descargó cosas de GitHub igualmente. Otro vio a un agente contestar un issue de GitHub en mitad de un escaneo. Nunca dejes
~/.aws,~/.sshni.enval alcance del agente. - Severidad por precondiciones, no por categoría. Cero precondiciones y remoto sin autenticar: alta. Una o dos, o con autenticación: media. Tres o más, o solo local: baja.
- No pidas al modelo que calcule CVSS. Que escriba el vector y calcula la puntuación con una herramienta (la librería
cvssde Python o la calculadora del NVD). - Pide variantes de forma explícita. Por defecto el modelo arregla solo la línea que le enseñas. Pídele que busque el mismo patrón en otras llamadas y la misma clase de bug en el resto del código.
- Convierte hallazgos en reglas Semgrep o CodeQL para que el patrón se detecte en CI sin volver a gastar tokens.
- Si escaneas proyectos open source, trata cada hallazgo como una pista, no como un informe. Reprodúcelo contra una versión publicada, comprueba que las rutas y líneas citadas existen, repórtalo por el canal privado de su
SECURITY.mdy di que intervino una IA.
Errores frecuentes
run se niega a arrancar fuera del sandbox. Es intencionado. Ejecuta ./scripts/setup_sandbox.sh y lanza siempre con bin/vp-sandboxed, no con .venv/bin/vuln-pipeline directamente.
gVisor no gestiona cgroups dentro de un contenedor o una VM anidada. El script lo detecta al verificar y vuelve a registrar runsc con --ignore-cgroups; según docs/agent-sandbox.md el aislamiento no cambia.
/triage descarta todos los hallazgos del canary como falsos positivos. También es esperado: entry.c se declara como código de demostración vulnerable y /triage excluye bugs en código de test o fixtures. Para ver el flujo completo usa el fixture /triage .claude/skills/triage/fixtures/canary-findings.json --repo targets/canary o apunta a tu propio código.
El CVE de dr_flac no aparece nunca. Es de clase DoS y el listón por defecto lo descarta. Añade --accept-dos.
Un agente find se queda colgado. No bloquea la escritura de resultados; mátalo con docker rm -f find_drlibs_<N>.
Los subagentes usan otro modelo. Fija CLAUDE_CODE_SUBAGENT_MODEL antes de abrir Claude Code; docs/troubleshooting.md lo trata en detalle.
Preguntas frecuentes
¿Necesito Docker para empezar? No. Las skills del día 1 (/threat-model, /vuln-scan, /triage y /patch sobre hallazgos estáticos) solo leen y escriben archivos. Docker y gVisor hacen falta para el pipeline autónomo.
¿Funciona con lenguajes distintos de C y C++? Las skills son agnósticas al lenguaje. El pipeline autónomo viene preparado para C/C++ con ASAN y hay que portarlo con /customize respondiendo a las tres preguntas de la tabla anterior.
¿Aplica los parches solo? No. Los diffs de /patch en modo estático son inertes y en modo pipeline la escalera de comprobaciones verifica que el crash desaparece, no que el diff se pueda subir tal cual. Un humano tiene que revisarlo.
¿Es lo mismo que Claude Security? No. Claude Security es el producto gestionado de Anthropic. Este repositorio es una implementación de referencia abierta y sin mantenimiento para construir tu propio pipeline.
¿Qué licencia tiene? Apache-2.0. Puedes usarlo y modificarlo, también comercialmente, conservando la licencia si lo redistribuyes.
Conclusión
defending-code-reference-harness no es la herramienta que vas a dejar corriendo en producción, sino el mapa de cómo montarla: modelo de amenazas primero, descubrimiento ruidoso, verificación independiente con PoC, triaje por precondiciones y parches que se vuelven a atacar. Empieza por el día 1 con tu propio código y un THREAT_MODEL.md; solo cuando el volumen de hallazgos lo justifique, monta el sandbox.
Si quieres una revisión más ligera para cada cambio, mira la skill OWASP para Claude Code o security-audit de Cloudflare. Y si vas a dar herramientas a tus agentes, lee antes cómo evitar el prompt injection en agentes de IA.
// código fuente
// kit para agencias
// implementación
Más sobre Agentes de IA
- Skills para tus agentes
- Claude Code
- Skills para tus agentes
- Claude Code

- Skills para tus agentes
- Claude Code