Open Code Review: el revisor de código con IA de Alibaba, explicado a fondo
Open Code Review (el comando se llama ocr) es una herramienta de línea de comandos que revisa tus cambios de Git con un modelo de lenguaje y devuelve comentarios anclados a líneas concretas, igual que haría un compañero en un pull request. Nació como el asistente interno de revisión de código de Alibaba y, según el propio repositorio, durante dos años lo usaron decenas de miles de desarrolladores antes de publicarlo como open source bajo licencia Apache-2.0.
En esta guía de cinco partes lo hemos instalado y probado a fondo (v1.13.2, publicada el 20 de octubre de 2026) sobre una API de ejemplo con errores plantados. En esta primera parte verás qué es, cómo funciona por dentro, qué dice su benchmark y cuándo tiene sentido frente a pedirle una revisión a Claude Code a secas.
Qué es Open Code Review y qué problema resuelve
La idea de fondo es simple: si le pides a un agente generalista "revisa este diff", el resultado depende demasiado del prompt y del humor del modelo. El README de Open Code Review enumera tres fallos que cualquiera que lo haya intentado reconocerá:
- Cobertura incompleta. En cambios grandes el agente "recorta camino" y revisa solo algunos archivos.
- Posiciones que se desplazan. El comentario dice "línea 42" y el problema está en la 57, o en otro archivo.
- Calidad inestable. Una skill escrita en lenguaje natural es difícil de depurar, y pequeños cambios en el prompt cambian mucho el resultado.
Su respuesta es mezclar ingeniería determinista (código normal que no se equivoca) con un agente LLM solo donde hace falta criterio. Qué archivos se revisan, qué reglas se aplican a cada uno y en qué línea cae cada comentario lo decide código Go; qué está mal en ese código lo decide el modelo.
| Dato | Valor |
|---|---|
| Repositorio | [alibaba/open-code-review](https://github.com/alibaba/open-code-review) |
| Versión probada | v1.13.2 (20/10/2026) |
| Licencia | Apache-2.0, Copyright 2026 Alibaba |
| Lenguaje | Go (binario estático) + wrapper npm |
| Instalación | `npm install -g @alibaba-group/open-code-review`, Homebrew, script o binario |
| Requisitos | Git ≥ 2.41 y un LLM (o un agente en modo delegación) |
| Proveedores | 30 integrados (Anthropic, OpenAI, Gemini, Bedrock, OpenRouter, DeepSeek, Mistral, xAI…) y cualquier endpoint compatible (Ollama, LiteLLM, pasarelas propias) |
| Integraciones | Claude Code, Codex, Cursor, Kimi Code, OpenCode, VS Code, GitHub Actions, GitLab CI, Gerrit, Bitbucket |
Sobre la licencia: este blog suele cubrir proyectos MIT. Apache-2.0 es igual de permisiva para usarlo en tu empresa o en proyectos de clientes (uso comercial, modificación y redistribución permitidos); añade una concesión explícita de patentes y te pide conservar el aviso de copyright y el archivo NOTICE si redistribuyes el software modificado.
Cómo funciona por dentro: el pipeline de una revisión
La documentación de arquitectura del repo describe con bastante detalle qué pasa al ejecutar ocr review. Lo hemos resumido en este esquema:
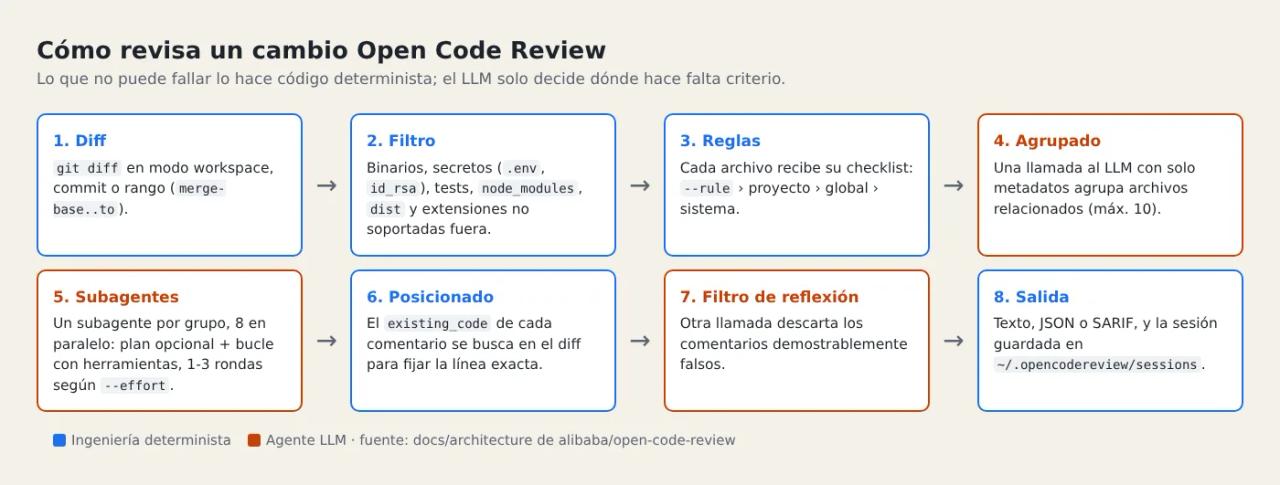
1. El diff
ocr obtiene los cambios con Git en uno de tres modos:
| Modo | Cómo se activa | Qué revisa |
|---|---|---|
| Workspace | `ocr review` sin flags | Cambios staged, unstaged y archivos nuevos sin seguimiento |
| Commit | `ocr review --commit abc123` | Lo que introdujo ese commit |
| Rango | `ocr review --from main --to mi-rama` | `merge-base(main, mi-rama)..mi-rama`, lo mismo que verías en el PR |
2. El filtro de archivos
Antes de gastar un solo token, cada archivo pasa por una serie de "puertas". Se descartan los binarios, las rutas con secretos (.env, .ssh/, id_rsa, .npmrc, .pypirc…), los tests (*.test.ts, *_test.go, test_*.py…), el código generado (*.pb.go, *.generated.*), las dependencias y salidas de build (node_modules, vendor, dist, target, .next…) y las extensiones que no están en su lista de tipos soportados. Lo verás en acción en la parte 2 con ocr review --preview.
La exclusión de secretos es interesante: ocurre antes de tus reglas y no se puede saltar con un include. Si alguien sube un .env por error, el contenido no viaja al LLM.
3. Las reglas por archivo
Cada archivo recibe su propia checklist de revisión. Hay reglas de sistema para más de 40 tipos de archivo (Java, Go, TypeScript, Python, PHP, Rust, SQL de MyBatis, package.json, workflows de GitHub Actions, Terraform, Solidity…) y puedes añadir o sustituir las tuyas por proyecto. Es el tema de la parte 3.
4. Agrupado semántico
Una única llamada al LLM, que solo ve metadatos (ruta, estado y líneas añadidas o borradas, nunca el código), agrupa los archivos relacionados: el handler con su servicio, o los messages_en.properties y messages_es.properties. Cada grupo tiene como máximo 10 archivos. Si esa llamada falla, se revisa un archivo por grupo, sin más.
5. Subagentes en paralelo
Cada grupo lo revisa un subagente con su propio contexto, 8 a la vez por defecto (--concurrency). Si el cambio es grande (un archivo con 50 o más líneas cambiadas, o un grupo que suma 100), primero hace una fase de plan que genera una checklist. Después entra en un bucle de hasta 100 rondas con seis herramientas: leer archivos, leer el diff de otro archivo, buscar en el código, buscar archivos, emitir un comentario (code_comment) y terminar (task_done).
El parámetro --effort decide cuántas pasadas hace: low = 1, medium = 2 (por defecto) y high = 3. Cada pasada recibe los hallazgos ya confirmados para buscar otros nuevos.
6, 7 y 8. Posicionado, filtro y salida
Cada comentario incluye el fragmento de código exacto al que se refiere (existing_code). Un algoritmo de ventana deslizante lo busca en el diff para calcular start_line y end_line; si falla, una llamada extra intenta reubicarlo. Al final, otra llamada al LLM (REVIEW_FILTER_TASK) revisa todos los comentarios y elimina los que son demostrablemente falsos. El resultado sale en texto, JSON o SARIF y queda guardado como sesión en ~/.opencodereview/sessions/.
El benchmark: precisión frente a exhaustividad
Alibaba publica un benchmark propio, AACR-Bench: 200 pull requests reales de 50 repositorios populares en 10 lenguajes, con 1.505 problemas anotados y validados por más de 80 ingenieros. El dataset está en Hugging Face.
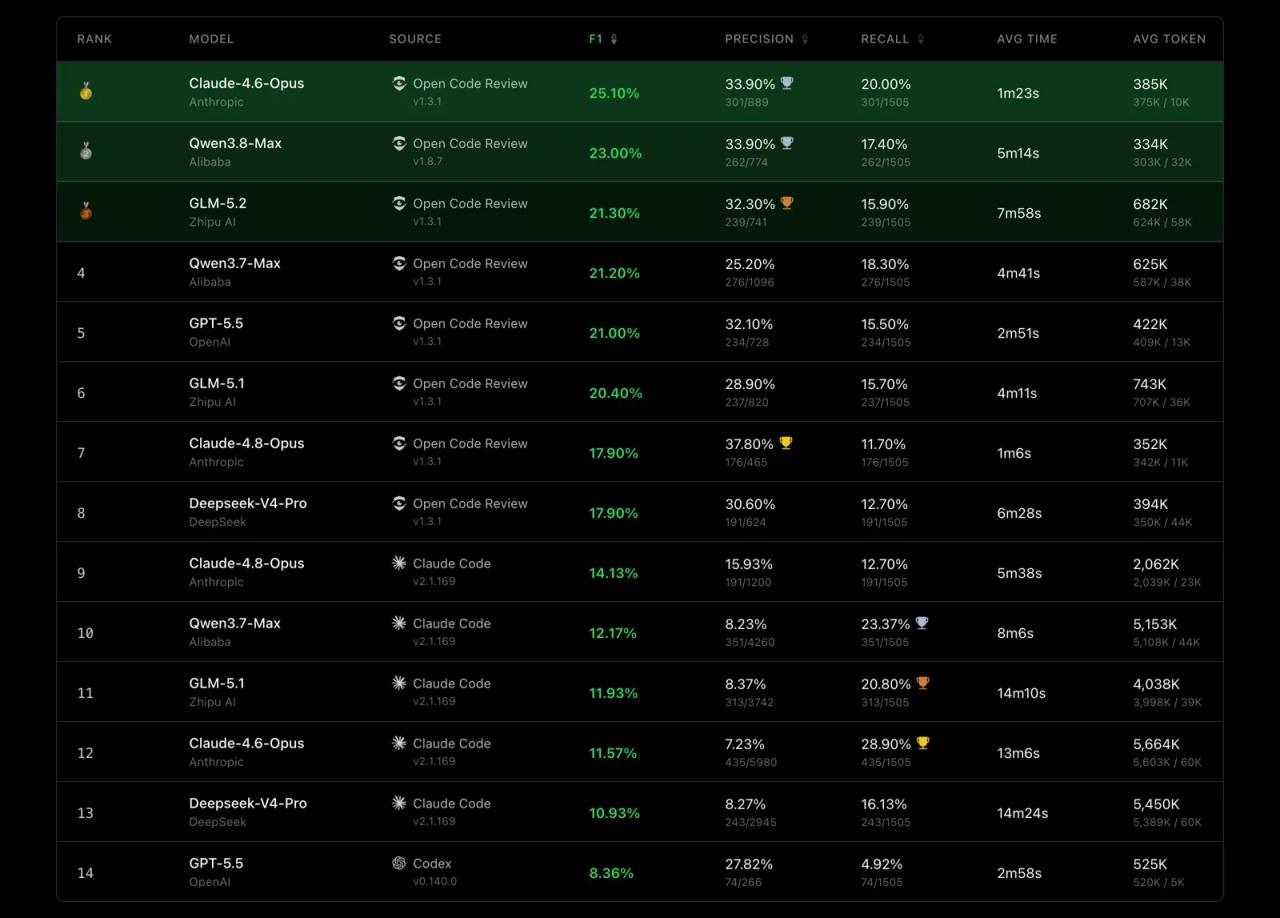
Las cifras que más llaman la atención, comparando el mismo modelo con y sin Open Code Review:
| Modelo | Herramienta | F1 | Precisión | Recall | Tokens medios |
|---|---|---|---|---|---|
| Claude 4.6 Opus | Open Code Review v1.3.1 | 25,10 % | 33,90 % | 20,00 % | 385K |
| Claude 4.6 Opus | Claude Code v2.1.169 | 11,57 % | 7,23 % | 28,90 % | 5.664K |
| Claude 4.8 Opus | Open Code Review v1.3.1 | 17,90 % | 37,80 % | 11,70 % | 352K |
| Claude 4.8 Opus | Claude Code v2.1.169 | 14,13 % | 15,93 % | 12,70 % | 2.062K |
Cómo leerlo:
- Precisión = de lo que reporta, cuánto es un fallo real. Open Code Review con Claude 4.6 Opus acierta en uno de cada tres comentarios; Claude Code a secas, en uno de cada catorce. Menos ruido que triar.
- Recall = de los fallos reales, cuántos encuentra. Aquí Claude Code gana (28,9 % frente a 20 %). El proyecto lo reconoce como una decisión deliberada: prefiere callarse a meter ruido. Su hoja de ruta incluye un "Ultra Mode" para quien quiera más recall a cambio de más tokens.
- Coste: unas 15 veces menos tokens en esa comparación (385K frente a 5.664K), y el README habla de "~1/9" de media.
Dos matices honestos: el benchmark lo diseñó y lo ejecutó el mismo equipo que hace la herramienta, y los números absolutos son bajos para todos (ninguno pasa del 26 % de F1). La revisión automática sigue siendo una primera criba, no un sustituto de la revisión humana.
Qué incluye el proyecto además del CLI
ocr scan: revisa archivos completos en lugar de un diff. Útil para auditar un repositorio heredado o una carpeta sin historial.- Modo delegación (
ocr delegate):ocrhace la parte determinista y tu agente (Claude Code, Codex, Cursor…) hace la revisión con su propia suscripción, sin API key. Lo probamos en la parte 4. - Plugins y skills para Claude Code, Codex, Cursor, Kimi Code y OpenCode, y una extensión de VS Code.
- CI/CD: una GitHub Action reutilizable y ejemplos para GitLab CI, Gerrit, Bitbucket Pipelines, GitFlic y Codeup. Lo vemos en la parte 5.
- Visor web de sesiones (
ocr viewer): reproduce cada revisión llamada a llamada para entender por qué el modelo dijo lo que dijo, y compara dos sesiones (hallazgos nuevos, persistentes y resueltos). - Cliente MCP: puedes darle al revisor herramientas externas, como consultar el ticket de Jira o tu documentación interna.
- Telemetría OpenTelemetry: tokens, peticiones y latencias por modelo, sin enviar nunca el contenido de los prompts.
Cuándo usar Open Code Review (y cuándo no)
Encaja bien si:
- Quieres una primera revisión automática en cada PR con poco ruido y coste predecible.
- Tu equipo tiene normas propias (seguridad, dinero en céntimos, transacciones) que quieres que se apliquen siempre, archivo por archivo.
- Ya pagas Claude Code, Codex o Cursor y quieres una revisión más rigurosa sin otra API key (modo delegación).
- Trabajas con PRs grandes, donde los agentes generalistas se saltan archivos.
No es para ti si:
- Buscas que arregle el código solo: la hoja de ruta lo descarta explícitamente. Sugiere cambios, pero aplicar correcciones siempre requiere aprobación humana (los plugins de Claude Code sí pueden aplicarlas, porque ahí es tu agente quien edita).
- Necesitas máximo recall en código crítico: hoy prioriza precisión.
- No puedes enviar código a un proveedor externo y no tienes un modelo local con soporte real de *tool calling* (con Ollama funciona, pero el modelo debe soportar llamadas a herramientas nativas;
deepseek-r1, por ejemplo, no sirve).
Preguntas frecuentes
¿Open Code Review es gratis? La herramienta sí (Apache-2.0). Pagas el modelo que uses: tu API key de Anthropic, OpenAI, DeepSeek, etc., o tu suscripción del agente en modo delegación. Con un modelo local en Ollama el coste es cero.
¿Envía mi código a Alibaba? No. Envía los diffs (y los fragmentos que el agente lea) al endpoint de LLM que configures tú. Las sesiones y las reglas se quedan en tu máquina, en ~/.opencodereview/.
¿Qué diferencia hay con CodeRabbit o Copilot code review? Esos son servicios gestionados. Open Code Review es un CLI que ejecutas tú, en local o en tu CI, con el modelo que elijas, y su lógica de selección y reglas es código abierto que puedes auditar.
¿Sirve para cualquier lenguaje? Trae reglas específicas para más de 40 tipos de archivo y una regla genérica para el resto. Los archivos con extensiones fuera de su lista de soportados se excluyen, salvo que los fuerces con include.
¿Funciona en Windows? Sí: hay binarios para Windows (amd64 y arm64), instalador de PowerShell y paquete npm.
Conclusión
Open Code Review es lo más parecido a un revisor de código con IA "industrial" que hay en abierto: toma lo que un agente hace mal en las revisiones (saltarse archivos, inventarse líneas, ruido) y lo sustituye por código determinista. A cambio, encuentra algo menos que un agente suelto, aunque lo que encuentra suele ser real.
En la siguiente parte lo instalamos, configuramos un proveedor y lanzamos la primera revisión: cómo instalar y usar Open Code Review.
// código fuente
// kit para agencias
// implementación
Más sobre Agentes de IA
- Skills para tus agentes
- Claude Code
- Skills para tus agentes
- Claude Code

- Skills para tus agentes
- Claude Code