Fish Speech: clonar voz con IA gratis o casi gratis (alternativa a ElevenLabs)
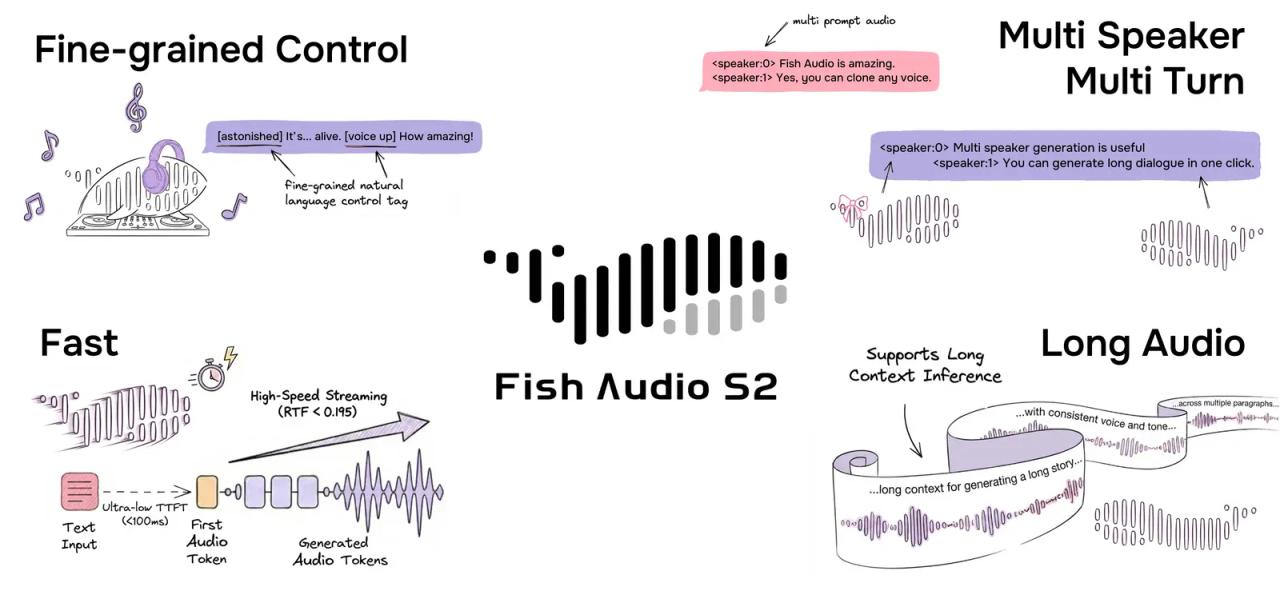
Fish Speech es el repositorio de código abierto de Fish Audio para convertir texto en voz (TTS) y clonar voces con modelos que puedes ejecutar en tu propio equipo o en una GPU alquilada. La versión 3.0 trae dos modelos: Drama 3, el nuevo buque insignia para escenas con varios personajes y audio largo, y S2-Pro, el modelo anterior, más pequeño, que cabe en una tarjeta gráfica de consumo. Los dos hablan español y clonan una voz con unos segundos de audio de referencia.
Aquí lo miramos con una pregunta en mente: ¿cuánto te cuesta tener voces de calidad para tus vídeos, cursos o tu app? Leímos el código, la documentación y las dos licencias, y comparamos los precios con ElevenLabs. Spoiler: hay una opción gratis, una muy barata y una trampa de licencia que conviene conocer antes de usarlo en un negocio.
Qué es Fish Speech y quién lo hace
- Repositorio: github.com/fishaudio/fish-speech
- Versión analizada: 3.0.0 (
pyproject.toml), commit0f8a12edel 30 de octubre de 2026. - Empresa: Fish Audio (39 AI, Inc.), que también vende la plataforma de pago fish.audio.
- Licencia: no es MIT. El código y Drama 3 usan la Fish Audio Community License v1.0 (13 de octubre de 2026) y los pesos de S2-Pro siguen con la Fish Audio Research License. Lo explicamos en detalle más abajo porque decide si lo puedes usar para ganar dinero.
- Stack: Python 3.12, PyTorch 2.8, un servidor HTTP propio y una interfaz web en React (*Awesome WebUI*) que ya viene incluida en la imagen Docker.
Fish Audio publica su informe técnico de Drama 3 en arXiv (2610.18010) y el de S2 (2603.08823), así que las cifras que citamos salen de ahí y del README.
Drama 3 y S2-Pro: qué hace cada modelo
| S2-Pro | Drama 3 | |
|---|---|---|
| Tamaño | 4.000 millones de parámetros | 35.000 millones, mezcla de expertos con 3.000 millones activos por token |
| Idiomas | Más de 80 (español incluido) | Los mismos que S2 |
| Clonación de voz | Sí, con 10-30 s de audio | Sí, con menos errores en varios idiomas |
| Etiquetas de emoción | `[pause]`, `[excited]`, `[whisper]`... | `[whisper]`, `[angry]`, `[laughing]`... con emociones más marcadas |
| Varios hablantes | Sí, con etiquetas `speaker:N` | Sí, escenas completas con hasta 16 hablantes |
| Editar una palabra del audio | No | Sí ("miércoles" → "jueves" sin regenerar todo) |
| Pedir otra toma ("más suave, más triste") | No | Sí, revisión por turnos |
| Hardware mínimo | GPU de 24 GB o CPU | GPU NVIDIA con 48 GB (FP8) |
| Licencia de los pesos | Research (no comercial) | Community (comercial con límites) |
En la práctica, S2-Pro es el modelo para probar en casa y Drama 3 el que tiene sentido para producir audio de verdad: narraciones largas, diálogos entre personajes, audiolibros o voces de un juego. Según el informe técnico, Drama 3 comete menos errores de pronunciación que ElevenLabs v4 en español, inglés, alemán y otros seis idiomas del conjunto de pruebas MiniMax Multilingual.
Los dos comparten la misma línea de comandos y el mismo servidor: el tipo de modelo se lee del config.json del checkpoint, así que cambiar de uno a otro es cambiar una ruta.
La licencia, en cristiano
Es lo más importante del artículo si piensas usarlo en un negocio, porque hay dos licencias distintas y cambian según el modelo que cargues.
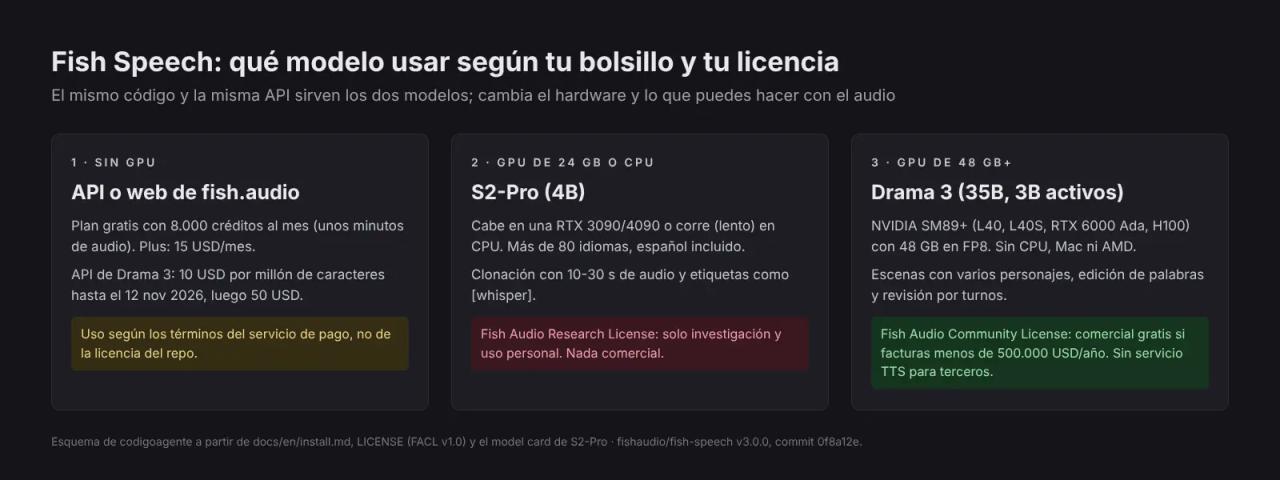
Drama 3 y el código: Fish Audio Community License
- Uso personal, pruebas e investigación: gratis, sin condiciones extra.
- Uso comercial: gratis mientras tú (y tus empresas vinculadas) facturéis menos de 500.000 USD al año, contando todos tus ingresos, no solo los que vengan del audio. Si pasas ese umbral, tienes 30 días para avisar a Fish Audio y 90 días de transición antes de necesitar una licencia de pago.
- Agencias y freelancers: puedes generar locuciones, doblajes o audiolibros y entregar solo el audio a clientes de cualquier tamaño. Si en cambio instalas el modelo en el servidor de un cliente, ese cliente también tiene que facturar menos de 500.000 USD.
- Lo que no puedes hacer sin pagar: montar un servicio de texto a voz para terceros (una API, una web o una app cuyo fin principal sea que otros generen voz o clonen voces). Sí puedes usar la voz dentro de tu propio producto: un asistente que responde hablando, los personajes de tu juego o la narración de tu app.
- Obligaciones: mostrar "Built with Fish Audio" en la web, la documentación o la página "acerca de" de lo que distribuyas, e incluir la licencia y un archivo
NOTICEsi redistribuyes el modelo o el código. - Prohibido siempre: imitar la voz de una persona identificable sin su consentimiento, suplantar a alguien para engañar, quitar marcas de agua del audio y usar las salidas para entrenar otro modelo de voz.
- El audio es tuyo "en la medida en que lo permita la ley aplicable".
S2-Pro: Fish Audio Research License
Los pesos de S2-Pro siguen con la licencia anterior, que solo permite investigación y uso no comercial (hobby, evaluación, pruebas). Cualquier uso ligado a un producto, un servicio o las operaciones internas de una empresa necesita una licencia comercial aparte. Si vas a vender un curso con voz generada o a usarla en anuncios, S2-Pro autoalojado no te sirve.
Un detalle: en Hugging Face, la ficha de Drama 3 dice en el texto que usa la Community License, pero sus metadatos todavía marcan la Research License. Manda el archivo LICENSE del repositorio, que nombra Drama 3 de forma explícita; si vas a basar un negocio en él, guarda una copia de la versión que aceptaste.
Qué necesitas para ejecutarlo
| Modelo | Memoria de GPU | Tarjetas válidas |
|---|---|---|
| Drama 3 | 48 GB como mínimo (FP8) | Solo NVIDIA. Para que quepa en una sola tarjeta hace falta arquitectura SM89 o superior (Ada o Hopper: L40, L40S, RTX 6000 Ada, H100). Sin CPU, Mac ni AMD. |
| S2-Pro | 24 GB recomendados | NVIDIA, CPU, AMD con ROCm (RDNA3/RDNA4) o Intel Arc |
Lo de SM89 sale del código: los expertos del modelo se quedan en FP8 solo si todas las GPU tienen núcleos FP8 (fp8_moe.py); en una tarjeta más antigua, como una RTX A6000 o una 3090, se descomprimen a 16 bits y el modelo ya no cabe en una sola GPU, así que necesitas varias. Sistema operativo: Linux o WSL en Windows.
Traducido a dinero:
- Una RTX 3090 o 4090 de 24 GB mueve S2-Pro. Si ya tienes una, el coste es la luz. Recuerda que solo vale para uso no comercial.
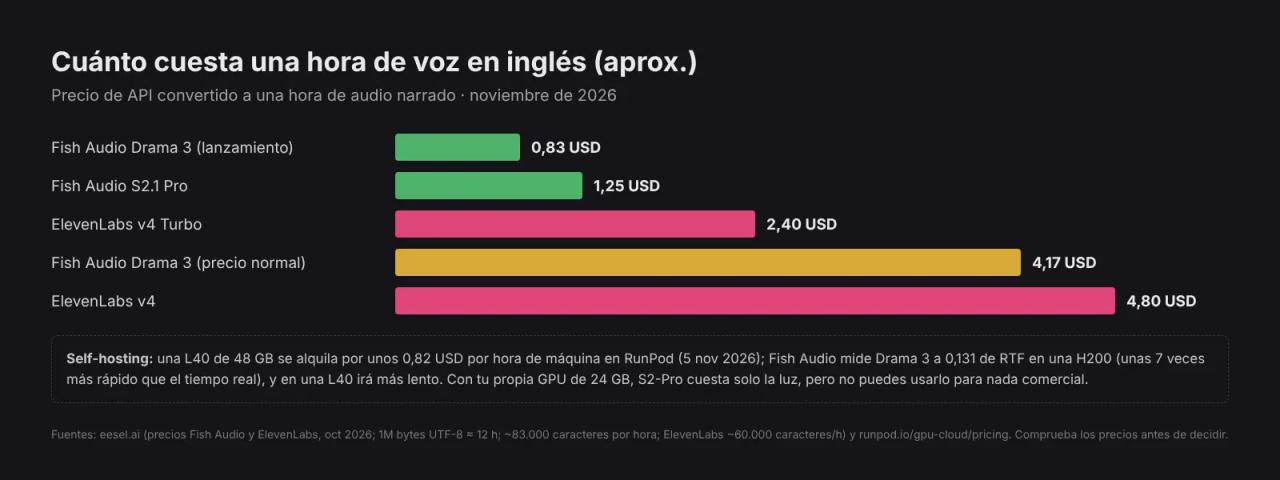
- Drama 3 en casa pide una tarjeta profesional de 48 GB, que cuesta miles de dólares. Para casi todo el mundo, lo razonable es alquilar la GPU por horas: en RunPod, una L40 de 48 GB salía a unos 0,82 USD por hora y una L40S a 1,09 USD el 5 de noviembre de 2026.
- Velocidad: Fish Audio mide Drama 3 en una H200 a un RTF de 0,131 con un solo flujo, es decir, unas siete veces más rápido que el tiempo real y con el primer audio en menos de 90 ms. En una L40 irá más lento; no lo hemos medido.
Instalar Fish Speech con Docker
La forma más corta es la imagen oficial con el servidor y la interfaz web. Primero descargas los pesos (necesitas la CLI de Hugging Face) y luego arrancas el contenedor:
pip install -U "huggingface_hub[cli]"
hf download fishaudio/s2-pro --local-dir checkpoints/s2-pro
hf download fishaudio/drama-3 --local-dir checkpoints/drama-3
Descarga también S2-Pro aunque solo vayas a usar Drama 3: si la carpeta de Drama 3 no trae codec.pth, el servidor usa el códec de checkpoints/s2-pro/codec.pth.
Para Drama 3 en una sola GPU SM89 o superior:
docker run --gpus device=0 \
    -v ./checkpoints:/app/checkpoints \
    -e LLAMA_CHECKPOINT_PATH=checkpoints/drama-3 \
    -p 8080:8080 \
    fishaudio/fish-speech:server-cuda
Para S2-Pro:
docker run --gpus all \
    -v ./checkpoints:/app/checkpoints \
    -e LLAMA_CHECKPOINT_PATH=checkpoints/s2-pro \
    -e DECODER_CHECKPOINT_PATH=checkpoints/s2-pro/codec.pth \
    -p 8080:8080 \
    fishaudio/fish-speech:server-cuda
Abre http://localhost:8080/ui para la interfaz web. Comprueba que el servidor responde con:
curl -X GET http://127.0.0.1:8080/v1/healthDebe devolver {"status":"ok"}. Si vas a exponerlo fuera de tu red, arráncalo con --api-key para exigir un token.
Sin Docker, la documentación usa uv sync --python 3.12 --extra cu129 (o --extra cpu) tras instalar portaudio19-dev libsox-dev ffmpeg.
Clonar una voz y generar audio por API
El servidor guarda voces de referencia con un identificador. Subes una grabación limpia con su transcripción:
curl -X POST http://127.0.0.1:8080/v1/references/add \
    -F id=mi-voz \
    -F "audio=@referencia.wav;type=audio/wav" \
    -F text="Transcripción exacta del audio de referencia"
Y generas audio con esa voz usando el cliente incluido:
python tools/api_client.py --url http://127.0.0.1:8080/v1/tts \
    --text "Hola, esta es mi voz clonada en local." \
    --reference_id mi-voz --format mp3 --output demo --no-play
Dos detalles que ahorran tiempo: el campo audio necesita su tipo MIME (;type=audio/wav) o el servidor no lo lee, y --no-play evita el error en servidores sin tarjeta de sonido. El endpoint principal es POST /v1/tts y el cuerpo va en msgpack, no en JSON, así que si lo llamas desde tu código usa el cliente como referencia.
Las emociones se marcan dentro del texto: [whisper] Esto es un secreto. [laughing] Era broma.. Con Drama 3, varios personajes se separan con <|speaker:0|>, <|speaker:1|>, etc.
Cuánto cuesta frente a ElevenLabs
Si no tienes GPU, Fish Audio vende el mismo modelo como servicio, y sale barato. Convertimos los precios públicos a una hora de audio narrado en inglés:
| Opción | Precio | Coste aprox. por hora de audio |
|---|---|---|
| Fish Audio Drama 3 (lanzamiento, hasta el 12 nov 2026) | 10 USD / millón de caracteres | 0,83 USD |
| Fish Audio S2.1 Pro | 15 USD / millón de bytes UTF-8 | 1,25 USD |
| ElevenLabs v4 Turbo | 0,04 USD / 1.000 caracteres | 2,40 USD |
| Fish Audio Drama 3 (precio normal) | 50 USD / millón de caracteres | 4,17 USD |
| ElevenLabs v4 | 0,08 USD / 1.000 caracteres | 4,80 USD |
Fuente de los precios y las conversiones (1 millón de bytes UTF-8 ≈ 12 horas de voz): eesel.ai, octubre de 2026. En español las tildes y la ñ ocupan dos bytes en UTF-8, así que lo que se cobra por bytes sale algo más caro que en inglés.
En la web de fish.audio hay además un plan gratis con 8.000 créditos al mes (unos minutos de audio), Plus a 15 USD/mes con 250.000 créditos y Pro a 100 USD/mes con 2 millones.
Qué opción te sale más barata
- Solo quieres probar o es para ti: el plan gratis de fish.audio o S2-Pro en tu propia GPU de 24 GB. Coste cero.
- Haces unos pocos vídeos o anuncios al mes para tu negocio: la API o el plan Plus de fish.audio. Pagas céntimos por minuto y no mantienes nada. Alquilar una GPU de 48 GB, descargar decenas de GB de pesos y montar el servidor no compensa para unos minutos de audio.
- Generas horas de audio a la semana (audiolibros, cursos largos, doblaje) o no puedes enviar los textos a un tercero: Drama 3 autoalojado en una GPU alquilada que enciendes solo mientras generas. Con licencia comercial gratis si facturas menos de 500.000 USD al año.
- Quieres vender un servicio de voz a otros: necesitas licencia comercial de Fish Audio. La Community License no cubre ese caso.
Si buscas algo con una licencia más simple, en el análisis de VoiceStudio repasamos motores con pesos Apache-2.0, como Kokoro o VoxCPM2, que puedes usar comercialmente sin umbrales de facturación.
Errores frecuentes
- "No cabe en memoria" con Drama 3 en una 3090, 4090 o A6000. Son tarjetas anteriores a SM89 o con 24 GB: los expertos FP8 se descomprimen y el modelo no entra. Usa S2-Pro o una L40/L40S/H100, o reparte el modelo entre varias GPU con
--device cuda:0,cuda:1,.... --compilefalla con Drama 3. No está soportado; solo funciona con S2-Pro y en Linux.- Silencio, ruido o "non-finite logits" en una V100. Las GPU anteriores a SM80 no tienen bfloat16 y la ruta en float16 aún no está probada en hardware real, según la propia documentación.
- Error al instalar
pyaudio. Instalaportaudio19-dev(oconda install pyaudio) y repite la instalación. - La voz clonada suena rara. La referencia debe ser una grabación limpia, de una sola persona, de 10 a 30 segundos, y la transcripción tiene que coincidir con lo que se oye.
Preguntas frecuentes
¿Fish Speech es gratis?
El código y los modelos se descargan gratis. Drama 3 se puede usar con fines comerciales sin pagar mientras tu facturación anual esté por debajo de 500.000 USD. S2-Pro solo es gratis para uso personal o investigación.
¿Fish Speech habla español?
Sí. Los dos modelos cubren más de 80 idiomas, y en el informe técnico Drama 3 tiene menos errores que ElevenLabs v4 en español.
¿Puedo usar la voz generada en anuncios o en un curso de pago?
Con Drama 3 autoalojado sí, si cumples el umbral de facturación, muestras "Built with Fish Audio" y la voz es tuya o tienes permiso de la persona. Con S2-Pro autoalojado no. Con la API de fish.audio dependes de los términos de tu plan de pago.
¿Funciona en Mac o sin tarjeta gráfica?
S2-Pro corre en CPU, aunque lento. Drama 3 necesita una GPU NVIDIA. Sin GPU, la opción práctica es la API de fish.audio.
Conclusión
Fish Speech pone en tus manos un modelo de voz que, según sus propias pruebas, compite con ElevenLabs, y lo hace con una licencia que deja usarlo gratis en negocios pequeños y medianos. La regla para gastar poco es sencilla: API de fish.audio para volúmenes bajos, Drama 3 en una GPU alquilada cuando generes horas de audio, y S2-Pro solo para experimentar. Antes de usarlo con clientes, lee el LICENSE del repositorio y consigue permiso por escrito de cualquier persona cuya voz clones.
Si vas a montar los vídeos donde entra esa voz, sigue con OpenMontage para producir vídeos con Claude Code o con HyperFrames, vídeos a partir de HTML.
// código fuente
// implementación
Más sobre Herramientas open source
- Diseño, imagen y vídeo
- Alternativas gratis a apps de pago
- Alternativas gratis a apps de pago
- Diseño, imagen y vídeo
- Diseño, imagen y vídeo
- Tutoriales paso a paso