VoiceStudio: clona voces, dobla vídeos y transcribe en local (alternativa open source a ElevenLabs)
VoiceStudio es una aplicación de escritorio open source para clonar voces, diseñar voces nuevas a partir de una descripción, doblar vídeos a otros idiomas, dictar y transcribir audio, todo con modelos que se ejecutan en tu propio equipo. Se presenta como alternativa local a servicios de pago como ElevenLabs, funciona en Windows, macOS y Linux (y en versión preliminar en Android e iPhone), y trae un servidor MCP para que agentes como Claude Code hablen con tu voz. Su licencia es AGPL-3.0 y la última versión es la 0.5.7, del 26 de octubre de 2026.
En este análisis leemos su código y su documentación para contarte qué hace, cómo funciona por dentro, qué necesitas para instalarlo y, sobre todo, qué puedes hacer legalmente con el audio que genera: ahí está la letra pequeña más importante.
Qué es VoiceStudio y quién lo hace
- Repositorio: github.com/debpalash/VoiceStudio
- Web: voicestudio.sh
- Versión analizada: 0.5.7 (26 de octubre de 2026), más los cambios de
mainhasta el commit85ff469del 27 de octubre. - Licencia: AGPL-3.0 para la aplicación. Los modelos que descarga tienen sus propias licencias (lo vemos más abajo). Hay una licencia comercial de pago para quien quiera integrarlo en un producto cerrado, y una edición VoiceStudio Pro con funciones extra.
- Autores: Palash Debnath (creador) y Shimul Debnath, que entró al equipo principal en esta versión. Las contribuciones se firman con un acuerdo de licencia (CLA).
- Estado: desarrollo muy activo. La 0.5.7 trae cientos de correcciones, apps móviles en preview y soporte para PC sin GPU.
El proyecto nació como "OmniVoice Studio", una interfaz para el modelo OmniVoice de k2-fsa, y por eso muchas variables de entorno todavía empiezan por OMNIVOICE_. Hoy es una suite completa con más de quince motores de voz intercambiables.
Qué puedes hacer con VoiceStudio
| Función | Qué hace |
|---|---|
| Clonación de voz | Subes una grabación limpia de referencia, escribes el texto y genera audio con esa voz. |
| Diseño de voz | Describes la voz ("mujer, adulta joven, tono grave, acento británico") y la crea sin audio de referencia. |
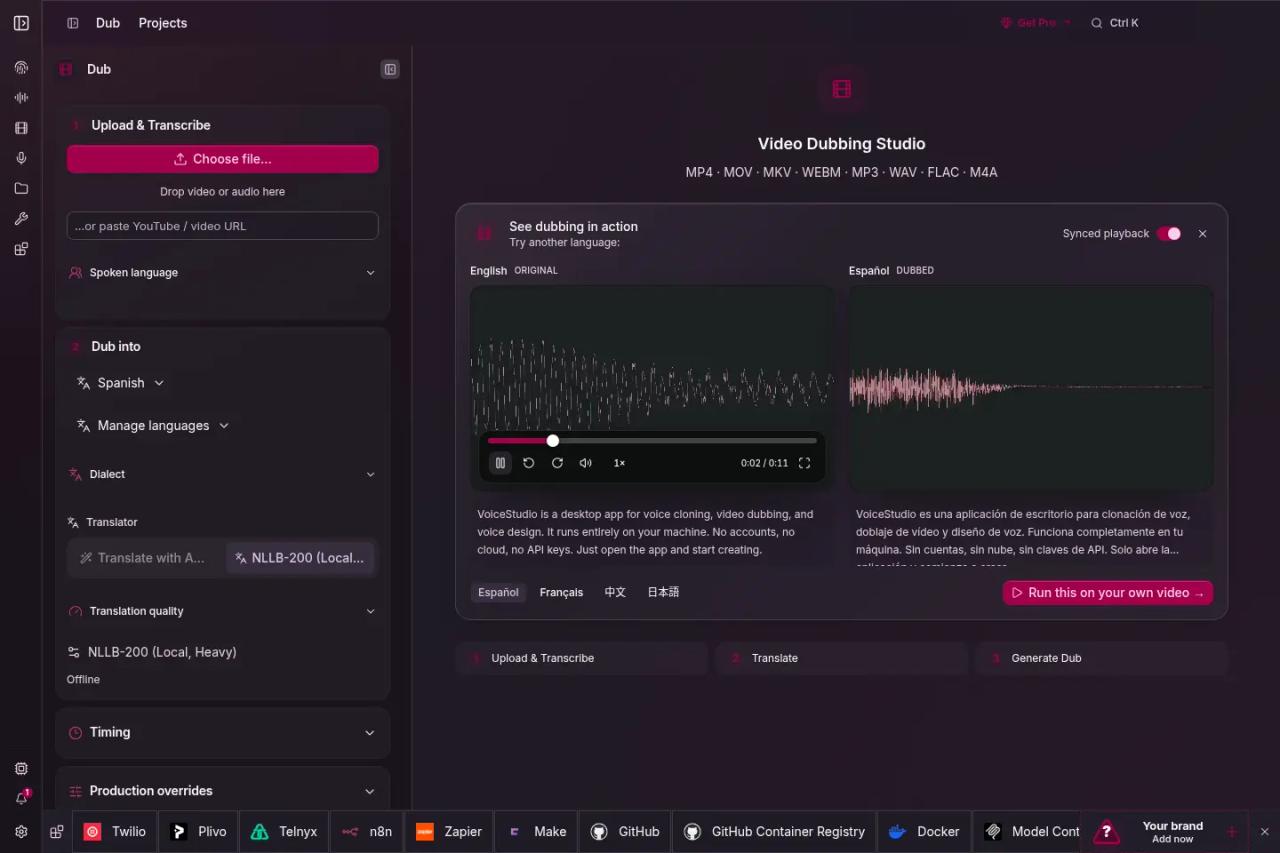
| Doblaje de vídeo | Transcribe un vídeo, traduce el texto, genera la voz en el idioma destino y ajusta los tiempos por segmento. |
| Dictado | Un widget flotante con atajo de teclado que transcribe lo que dices y lo inserta donde escribes. |
| Transcripción | Pasa audio a texto con Whisper, Parakeet u otros, y separa hablantes (diarización). |
| Historias y audiolibros | Textos largos por capítulos, varios personajes y trabajos por lotes. |
| Aislamiento vocal | Separa la voz de la música o el ruido de fondo. |
| API y MCP | Un servidor local compatible con la API de OpenAI y un servidor MCP para agentes. |
El propio README habla de 646 idiomas, que es la cifra del modelo OmniVoice. El español está incluido, y también lo soportan otros motores como VoxCPM2, IndexTTS, CosyVoice 3 o MOSS-TTS-Nano.
Cómo funciona por dentro
VoiceStudio tiene dos piezas: una app de escritorio hecha con Electron (la versión antigua con Tauri se retiró en la 0.5.3) y un backend en Python con FastAPI que escucha en localhost:3900. La app es solo un cliente más: tus scripts y tus agentes pueden hablar con el mismo backend.
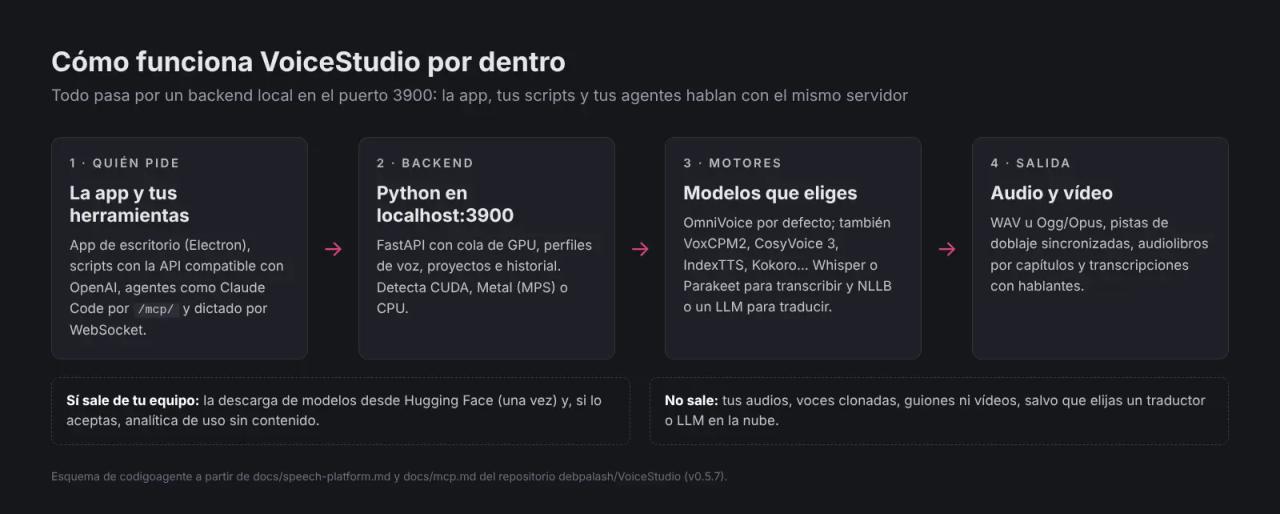
El backend mantiene los modelos cargados, gestiona una cola de GPU, guarda perfiles de voz, proyectos e historial, y detecta si tienes CUDA (NVIDIA), Metal (Apple Silicon) o solo CPU. Los motores se instalan desde el catálogo de modelos de la app; algunos corren en un proceso aparte con su propio entorno de Python.
| Tarea | Motores incluidos |
|---|---|
| Generar voz | OmniVoice (por defecto), VoxCPM2, CosyVoice 3, IndexTTS 2.5, MOSS-TTS, KittenTTS, Kokoro (vía MLX-Audio o sherpa-onnx), GPT-SoVITS, Supertonic-3, PocketTTS, dots.tts, Confucius4-TTS |
| Transcribir | WhisperX (por defecto), Faster-Whisper, MLX Whisper, Parakeet TDT, Moonshine, FunASR, sherpa-onnx, whisper.cpp |
| Traducir (doblaje) | NLLB-200 local, Argos, Google o un LLM que configures |
Requisitos de hardware
| Equipo | Qué esperar |
|---|---|
| NVIDIA en Windows o Linux | Aceleración CUDA, la opción más rápida. |
| Mac con Apple Silicon (M1-M5) | Aceleración Metal. |
| PC sin GPU dedicada | Funciona en CPU, más lento. Instala una versión ligera de PyTorch (unos 5 GB libres). Conviene elegir motores ligeros como KittenTTS, Supertonic-3 o PocketTTS. |
| AMD Radeon en Windows | CPU por defecto; ROCm opcional en hardware compatible y Vulkan con algunos motores GGUF. |
| Mac Intel | Solo la interfaz, conectada a un backend remoto. |
| Android 10+ / iOS 17+ | Versión preliminar, los modelos corren en el teléfono. |
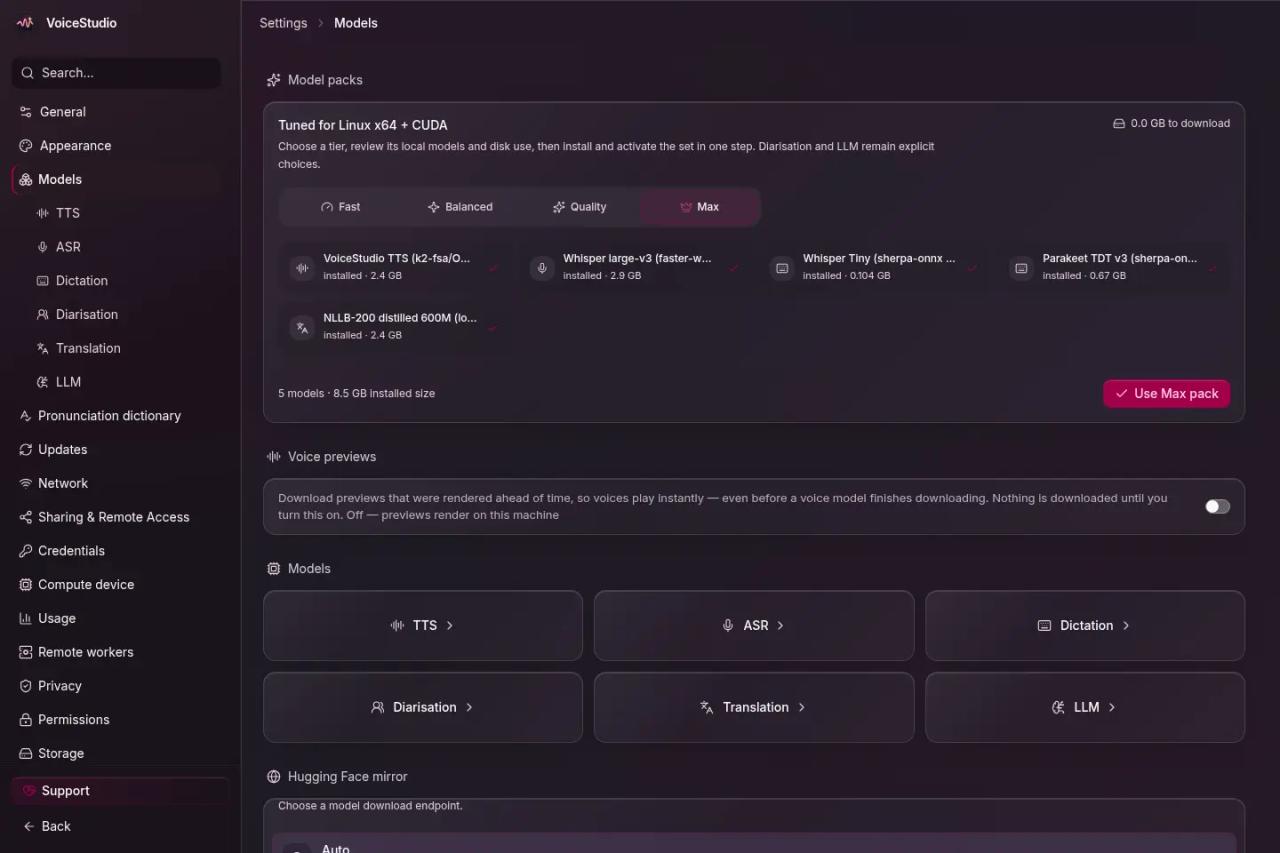
En Windows calcula unos 10 GB libres para la app, su entorno de Python y los modelos. Solo el modelo de OmniVoice pesa unos 2,3 GB, y el paquete "Max" de la captura llega a 8,5 GB. La primera generación tras arrancar siempre es la más lenta, porque carga los pesos en memoria.
Cómo instalar VoiceStudio
En Windows, descarga VoiceStudio-0.5.7-win-x64.exe desde la página de versiones o deja que el script oficial elija y verifique el instalador desde un PowerShell normal (sin administrador):
irm https://voicestudio.sh/install.ps1 | iexEn macOS y Linux:
curl -fsSL https://voicestudio.sh/install | shEl instalador de Windows todavía no está firmado, así que SmartScreen puede avisarte; compara el archivo con SHA256SUMS.txt de la versión antes de ejecutarlo. En el primer arranque la app descarga Python, FFmpeg y los modelos que elijas.
Si los motores van a ocupar mucho en C:, puedes moverlos a otro disco antes de abrir la app:
[Environment]::SetEnvironmentVariable('OMNIVOICE_ENGINES_DIR', 'D:\VoiceStudio\engines', 'User')También hay imagen Docker (ghcr.io/debpalash/voicestudio:stable) para servidores con GPU, que sirve la interfaz por navegador y exige una clave de administrador (OMNIVOICE_API_KEY).
Clonar y diseñar una voz
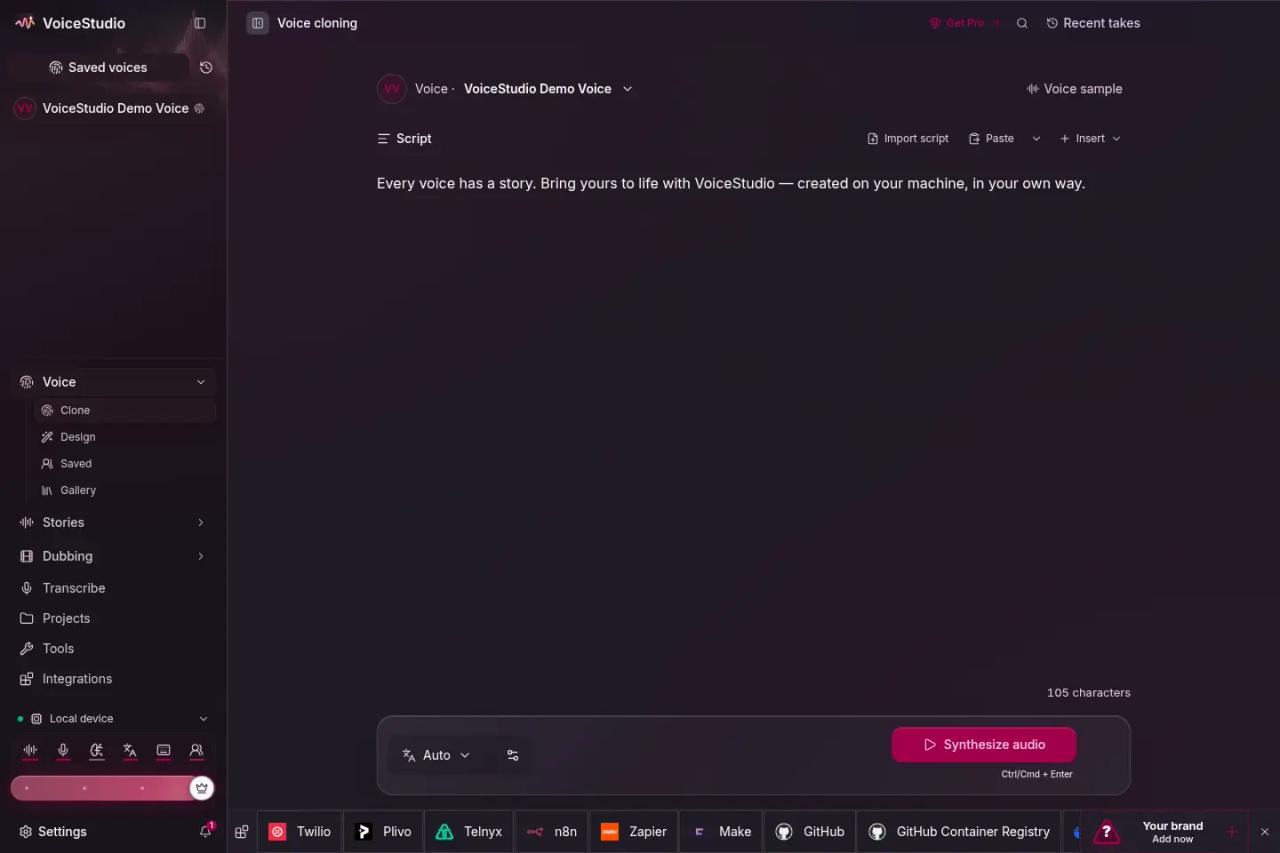
Para clonar, abre *Voice → Clone*, elige una voz guardada o añade una grabación limpia de referencia, escribe el guion y pulsa Synthesize audio. La app transcribe la grabación de referencia una vez y guarda el texto en el perfil; si ese campo queda vacío, cada generación vuelve a transcribir y todo va mucho más lento.
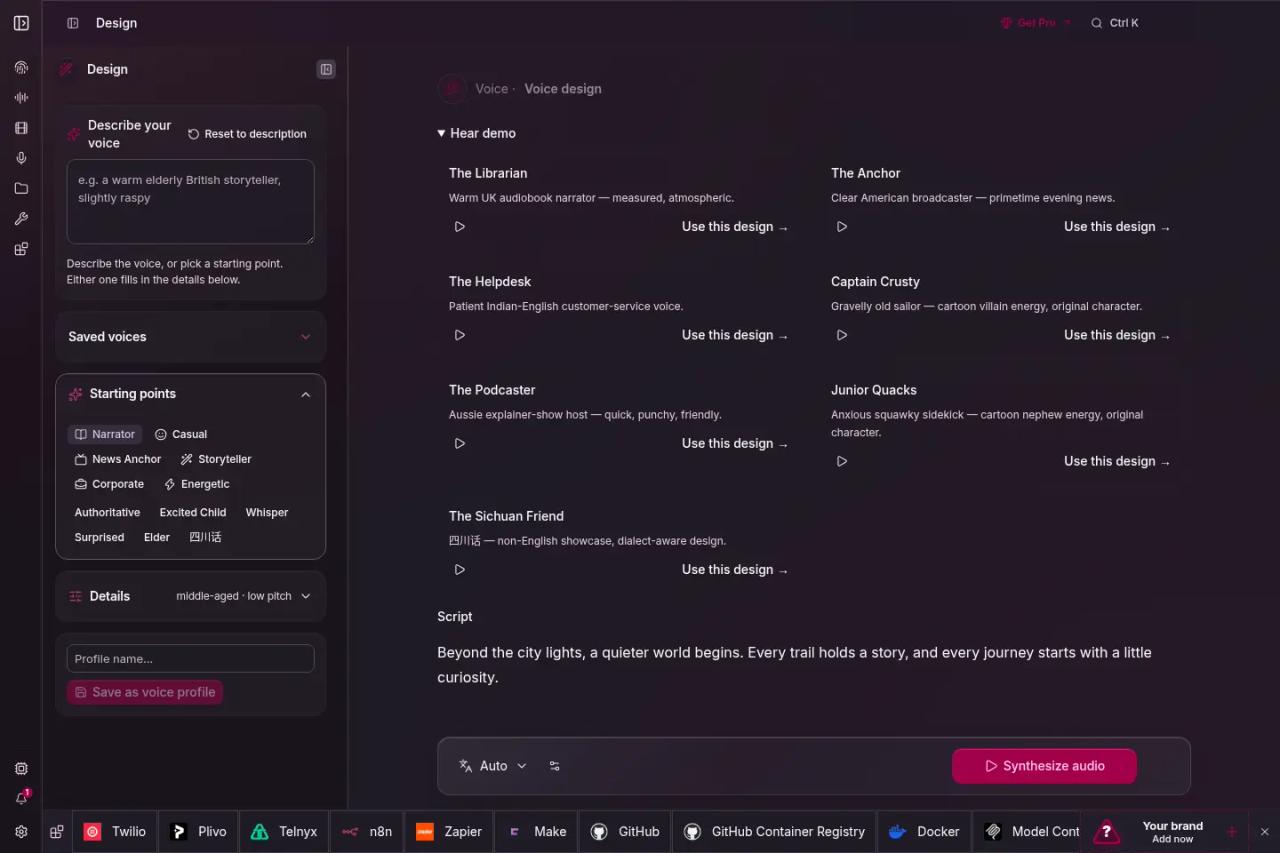
Para diseñar, abre *Voice → Design* y describe la voz o parte de un punto de partida (narrador, presentador de noticias, corporativo, susurro...). Por dentro, la descripción se convierte en atributos de género, edad, tono, estilo y acento. El diseño se guarda como perfil con una semilla fija, así que la voz suena igual cada vez.
Usar VoiceStudio desde Claude Code (MCP) y desde tus scripts
Con la app abierta, el servidor MCP ya está montado en http://localhost:3900/mcp/. En Integrations la app exporta la configuración lista para Claude Code, Cursor o Codex. A mano, en Claude Code sería:
claude mcp add --transport http voicestudio http://127.0.0.1:3900/mcp/ --header "X-OmniVoice-Client-Id: claude-code"El encabezado X-OmniVoice-Client-Id sirve para asignar una voz fija a cada agente. Las herramientas que expone son generate_speech, clone_voice, design_voice, describe_voice, transcribe, list_voices y check_health. Un detalle útil: por defecto el audio vuelve al agente en base64, lo que gasta mucho contexto. Con OMNIVOICE_MCP_OUTPUT_MODE=files y OMNIVOICE_MCP_BASE_PATH apuntando a una carpeta, el agente recibe solo la ruta del archivo.
Para scripts, la API imita la de OpenAI, así que cualquier SDK que ya uses sirve cambiando la URL:
curl --fail-with-body http://localhost:3900/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model":"tts-1","voice":"<id-de-tu-voz>","input":"Hola, esto es una prueba.","response_format":"wav"}' \
  --output prueba.wav
tts-1 y los nombres de voz de OpenAI son solo alias de compatibilidad; para resultados repetibles usa el identificador de una voz guardada, que obtienes en GET /v1/audio/voices. Para transcribir está POST /v1/audio/transcriptions, y para texto en vivo un WebSocket en /v1/audio/transcriptions/stream. El repositorio incluye además una skill (npx skills add debpalash/VoiceStudio) que enseña a un agente a usar todo esto.
Licencia: qué puedes hacer con VoiceStudio y con el audio
Aquí hay dos capas distintas y conviene no mezclarlas.
1. La aplicación es AGPL-3.0. Puedes usarla gratis, también en tu empresa o para clientes. La AGPL solo te obliga a algo si modificas VoiceStudio y ofreces esa versión modificada a otros por red (por ejemplo, como servicio web): entonces tienes que publicar tu código con la misma licencia. Si quieres meterlo en un producto cerrado sin esa obligación, el autor vende una licencia comercial.
2. Cada modelo tiene su propia licencia, y aquí está la trampa. El modelo por defecto, OmniVoice, publica sus pesos con licencia CC-BY-NC (no comercial), y lo mismo pasa con NLLB-200, el traductor local del doblaje. Desde la 0.5.7 la app te pide aceptar esas licencias una vez en el catálogo de modelos, y hasta entonces la API y el MCP devuelven un error de licencia al usarlos.
Otros motores publican sus pesos con licencias más abiertas según sus fichas: VoxCPM2, CosyVoice 3, MOSS-TTS y Kokoro aparecen como Apache-2.0, y varios Whisper como MIT. Ojo: el inventario de licencias del propio proyecto (docs/licensing/model-inventory.md) aclara que todavía no ha certificado ningún modelo para uso comercial; la etiqueta es la que declara cada autor y te toca revisarla a ti.
En la práctica: si vas a usar la voz en algo que vendes (anuncios, vídeos de producto, un curso de pago), no uses OmniVoice ni NLLB; elige un motor con licencia comercial, revisa su ficha en Hugging Face y guarda el enlace.
Y una regla que no depende de licencias: clona solo voces con permiso de su dueño. El README lo pide expresamente, y usar la voz de otra persona sin consentimiento puede infringir derechos de imagen y protección de datos en la mayoría de países. Si te preocupa este tema, lo tratamos en riesgos legales de las apps hechas con IA.
Límites y errores frecuentes
- "Can't reach the local backend": suele ser falta de memoria. Con 16 GB y un navegador lleno de pestañas, el sistema puede matar el backend durante un doblaje. Cierra cosas o descarga modelos en *Settings → Models*.
- Todo va lentísimo: comprueba en *Settings → Performance* si estás en
cpusin saberlo. En Windows la aceleración de PyTorch solo funciona con NVIDIA; una Radeon cae a CPU. - Error de licencia al llamar a la API o al MCP: no has aceptado la licencia de OmniVoice en el catálogo de modelos.
- La primera llamada MCP caduca: si el modelo de OmniVoice no estaba descargado, la primera generación lo baja (unos 2,3 GB) dentro del tiempo de espera. Instálalo antes desde la app.
- SmartScreen bloquea el instalador: el
.exeno está firmado todavía; verifica el SHA-256 y continúa. - Docker por nombre de host da error: desde la 0.5.7 hay que añadir ese nombre a
OMNIVOICE_ALLOWED_HOSTS.
Qué comprobamos nosotros
Leímos el código y la documentación del repositorio en el commit 85ff469 (27 de octubre de 2026): el README, el changelog de la 0.5.7, las guías de instalación, la del MCP, la de la API local y el inventario de licencias de modelos (backend/config/model_licenses.json). No pudimos generar audio en nuestro entorno de pruebas porque no tiene acceso a las descargas de modelos de Hugging Face, así que las capturas de la app son las oficiales del proyecto y el esquema es nuestro.
Preguntas frecuentes
¿VoiceStudio es gratis?
Sí. La app es open source con licencia AGPL-3.0 y puedes usarla sin pagar, también con fines comerciales. Lo que se paga es VoiceStudio Pro (funciones como trabajadores remotos o compartir GPU) y la licencia comercial para integrarlo en un producto cerrado.
¿Funciona sin internet?
Una vez descargados los modelos, la clonación, el diseño, la transcripción y el doblaje con NLLB funcionan sin conexión. Necesitas internet para descargar modelos y si eliges un traductor o un LLM en la nube.
¿Habla bien en español?
El español está soportado por OmniVoice y por varios motores alternativos (VoxCPM2, IndexTTS, CosyVoice 3, MOSS-TTS-Nano). La calidad depende del motor y de la grabación de referencia: una muestra limpia, sin música y con su transcripción correcta da mucho mejor resultado.
¿Puedo usar el audio en vídeos comerciales o anuncios?
Depende del modelo, no de la app. Con OmniVoice (por defecto) no, porque sus pesos son no comerciales. Con motores que declaran Apache-2.0 o MIT, como VoxCPM2 o CosyVoice 3, en principio sí, revisando su ficha. Y siempre con una voz propia o con permiso.
¿Qué diferencia hay con ElevenLabs?
ElevenLabs es un servicio en la nube de pago por uso con voces muy pulidas y sin instalar nada. VoiceStudio es gratis y local: tus audios no salen del equipo y no pagas por minuto, pero dependes de tu hardware y de revisar tú las licencias de cada modelo.
¿Necesito una tarjeta gráfica?
No es obligatoria. Sin GPU funciona en CPU con motores ligeros, pero mucho más lento. Para doblar vídeos largos, una NVIDIA o un Mac con Apple Silicon marcan la diferencia.
Conclusión
VoiceStudio junta en una sola app lo que antes eran cinco herramientas: clonación, diseño de voz, doblaje, dictado y transcripción, con una API y un MCP que lo convierten en la voz de tus agentes. Es gratis y local, pero la licencia del modelo por defecto no permite uso comercial: si lo vas a usar para algo que vendes, cambia de motor antes de grabar nada.
Si te interesan las herramientas open source para crear contenido, sigue con HyperFrames, para crear vídeos con HTML o con Recordly, el grabador de pantalla con zoom automático.
// implementación
Más sobre Herramientas open source
- Alternativas gratis a apps de pago
- Instálalo en tu servidor
- Diseño, imagen y vídeo
- Alternativas gratis a apps de pago
- Alternativas gratis a apps de pago
- Diseño, imagen y vídeo